در دنیای امروزی که دادهها به یکی از ارزشمندترین داراییهای سازمانها و شرکتها تبدیل شدهاند، حفظ حریم خصوصی و امنیت اطلاعات به چالش بزرگی تبدیل شده است. یکی از راهکارهای نوین که در سالهای اخیر توجه بسیاری از محققان و شرکتهای فناوری را به خود جلب کرده، یادگیری فدرال (Federated Learning) است. این روش آموزش مدلهای هوش مصنوعی بدون نیاز به انتقال دادههای واقعی کاربران یا سازمانها، امکان توسعه مدلهای قدرتمند را فراهم میکند. اما چگونه این روش کار میکند؟ چه مزایا و محدودیتهایی دارد؟ و چگونه میتوان از آن به بهترین نحو استفاده کرد؟ در این مقاله به بررسی مفاهیم اساسی یادگیری فدرال، نحوه عملکرد آن، کاربردهای عملی، نکات مهم و همچنین اشتباهات رایج در استفاده از این روش میپردازیم.
یادگیری فدرال چیست؟
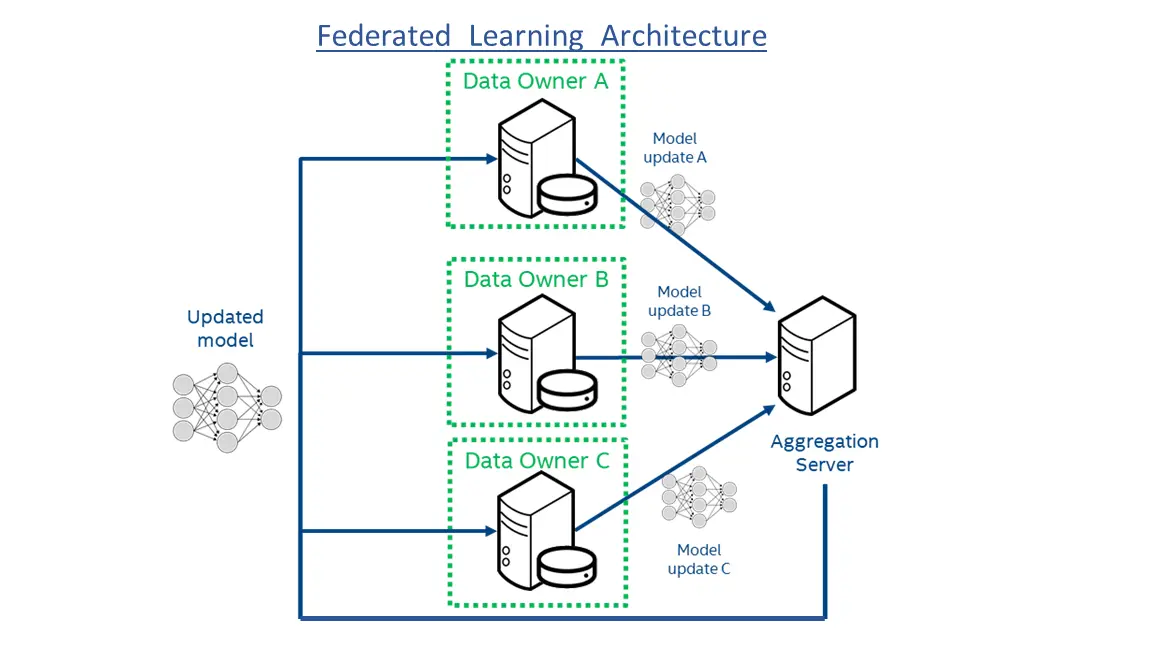
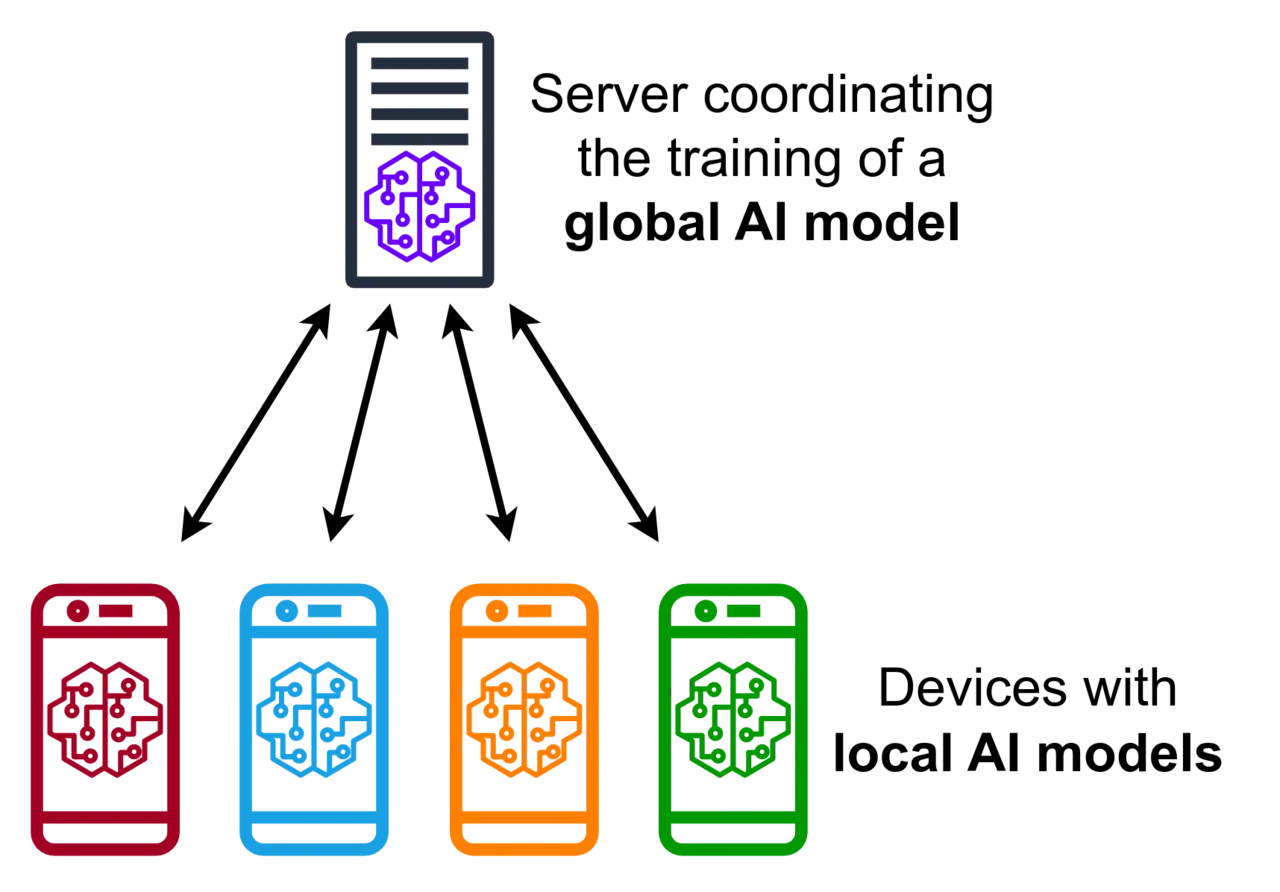
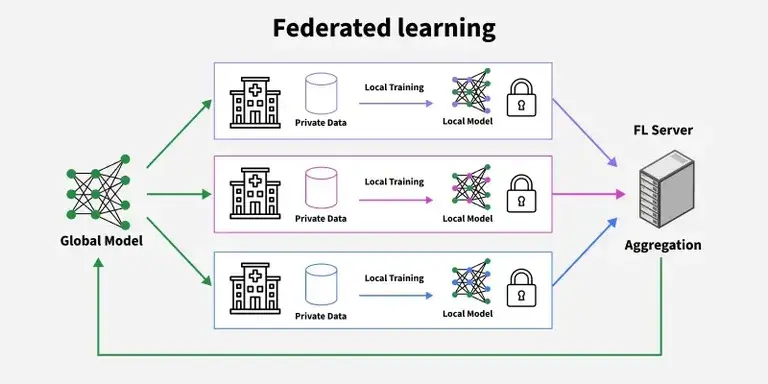
یادگیری فدرال یک پارادایم نوین در یادگیری ماشین است که در آن مدلهای هوش مصنوعی بر اساس دادههای محلی و پراکنده در دستگاههای مختلف (مانند گوشیهای هوشمند، سرورهای سازمانی یا دستگاههای IoT) آموزش میبینند. در این روش، دادههای خام هرگز از دستگاههای محلی خارج نمیشوند و تنها پارامترهای مدل (مثل وزنهای شبکه عصبی) بین دستگاهها و یک سرور مرکزی مبادله میشوند.
این روش به ویژه در مواردی که دادهها حساس هستند یا انتقال آنها با محدودیتهای قانونی یا اخلاقی همراه است، بسیار مفید است. برای مثال، شرکتهایی مانند گوگل از یادگیری فدرال برای بهبود عملکرد خدمات خود بدون نیاز به دسترسی به دادههای شخصی کاربران استفاده میکنند.
چگونه یادگیری فدرال بدون انتقال اطلاعات خصوصی مدل آموزش میبیند؟
در یادگیری فدرال، فرآیند آموزش به صورت توزیعشده انجام میشود. در این روش:
- دادهها در محل باقی میمانند: دادههای هر کاربر یا سازمان در دستگاه محلی یا سرور محلی ذخیره میشوند و هیچگاه به خارج از آن منتقل نمیشوند.
- مدل محلی آموزش میبیند: هر دستگاه یا سازمان یک نسخه محلی از مدل را بر اساس دادههای خود آموزش میدهد.
- پارامترهای مدل به اشتراک گذاشته میشوند: تنها پارامترهای بهروزرسانی شده مدل (مثل وزنهای شبکه عصبی) بین دستگاهها و سرور مرکزی مبادله میشوند.
- سرور مرکزی مدل را بهروزرسانی میکند: سرور مرکزی پارامترهای دریافت شده را ترکیب کرده و مدل جهانی را بهروزرسانی میکند.
- فرآیند تکرار میشود: این چرخه تا رسیدن مدل به دقت مورد نظر تکرار میشود.
این روش اطمینان میدهد که دادههای حساس هرگز خارج از دستگاه محلی منتقل نمیشوند و تنها اطلاعاتی که مبادله میشود، پارامترهای مدل است که به خودی خود اطلاعات شخصی را فاش نمیکنند.
مزایا و کاربردهای یادگیری فدرال
یادگیری فدرال به دلیل ویژگیهای منحصر به فرد خود، در بسیاری از حوزهها کاربردهای گستردهای دارد. برخی از مزایا و کاربردهای این روش عبارتند از:
- حفظ حریم خصوصی: به دلیل عدم انتقال دادههای واقعی، این روش برای سازمانهایی که با دادههای حساس کار میکنند، بسیار مناسب است.
- کاهش هزینههای انتقال داده: انتقال دادههای بزرگ و حجمدار از دستگاههای محلی به سرور مرکزی نیازی نیست، که این امر هزینهها و مصرف باند را کاهش میدهد.
- بهبود دقت مدل در دادههای توزیعشده: مدل میتواند از دادههای پراکنده در دستگاههای مختلف استفاده کرده و دقت خود را افزایش دهد.
- کاربرد در دستگاههای با محدودیت: دستگاههایی مانند گوشیهای هوشمند یا دستگاههای IoT که از نظر محاسباتی محدود هستند، میتوانند با استفاده از یادگیری فدرال مدلهای خود را بهروزرسانی کنند.
- پاسخگویی به مقررات: این روش با قوانین حریم خصوصی مانند GDPR سازگار است و سازمانها را در رعایت مقررات قانونی یاری میکند.
از جمله کاربردهای عملی یادگیری فدرال میتوان به:
- بهبود عملکرد سیستمهای تشخیص گفتار در گوشیهای هوشمند بدون نیاز به انتقال دادههای صوتی کاربران.
- توسعه مدلهای پزشکی بر اساس دادههای بیمارستانی که انتقال آنها با محدودیتهای قانونی همراه است.
- بهبود سیستمهای توصیهگر در پلتفرمهای آنلاین بدون نیاز به دسترسی به دادههای شخصی کاربران.
نکات کاربردی در استفاده از یادگیری فدرال
اگر قصد استفاده از یادگیری فدرال را دارید، توجه به نکات زیر میتواند فرآیند را برای شما سادهتر کند:
- انتخاب الگوریتم مناسب: برخی الگوریتمهای یادگیری فدرال مانند FedAvg (Federated Averaging) برای شرایط خاص طراحی شدهاند. انتخاب الگوریتم مناسب بر اساس نیازهای پروژه بسیار مهم است.
- مدیریت دادههای غیرهمگن: در بسیاری از موارد، دادههای دستگاههای مختلف با یکدیگر متفاوت هستند. استفاده از روشهای مناسب برای مدیریت این عدم همگنی میتواند دقت مدل را بهبود بخشد.
- بهینهسازی ارتباطات: مبادله پارامترهای مدل بین دستگاهها و سرور مرکزی باید بهینه باشد. استفاده از روشهای فشردهسازی و کدگذاری میتواند این فرآیند را سریعتر کند.
- ارزیابی مداوم: مدلسازی مداوم عملکرد مدل و بررسی دقت آن در دستگاههای مختلف ضروری است. این کار میتواند به شناسایی مشکلات و بهبود مدل کمک کند.
- امنیت و حریم خصوصی: حتی اگر دادهها منتقل نمیشوند، باید از امنیت پارامترهای مدل و جلوگیری از حملات احتمالی اطمینان حاصل کرد.
چالشهای رایج و اشتباهات متداول
در حالی که یادگیری فدرال مزایای بسیاری دارد، اما با چالشهایی نیز همراه است. برخی از اشتباهات رایج و چالشهای این روش عبارتند از:
- عدم درک کامل فرآیند: بسیاری از توسعهدهندگان فکر میکنند که یادگیری فدرال تنها یک روش جایگزین برای یادگیری توزیعشده است، در حالی که تفاوتهای اساسی بین این دو وجود دارد.
- نادیده گرفتن عدم همگنی دادهها: اگر دادههای دستگاههای مختلف بسیار متفاوت باشند، مدل ممکن است عملکرد ضعیفی داشته باشد. مدیریت این عدم همگنی نیازمند دانش و تجربه است.
- کمبود منابع محاسباتی: برخی دستگاهها ممکن است از نظر محاسباتی محدود باشند و آموزش مدلهای پیچیده را برای آنها دشوار کند.
- عدم توجه به امنیت: حتی اگر دادهها منتقل نمیشوند، پارامترهای مدل میتوانند هدف حملات سایبری باشند. استفاده از روشهای امنیتی مناسب ضروری است.
- انتظار نتایج سریع: یادگیری فدرال ممکن است نسبت به روشهای سنتی کندتر باشد، زیرا فرآیند آموزش توزیعشده است. صبر و برنامهریزی مناسب ضروری است.
برای کسب اطلاعات بیشتر در مورد روشهای نوین یادگیری ماشین و کاربردهای عملی آنها، میتوانید به مقالات مرتبط در ماشین مگ مراجعه کنید.
یادگیری فدرال در دنیای واقعی: مثالها و مطالعات موردی
یادگیری فدرال در سالهای اخیر در پروژههای مختلف به کار گرفته شده است. برای مثال:
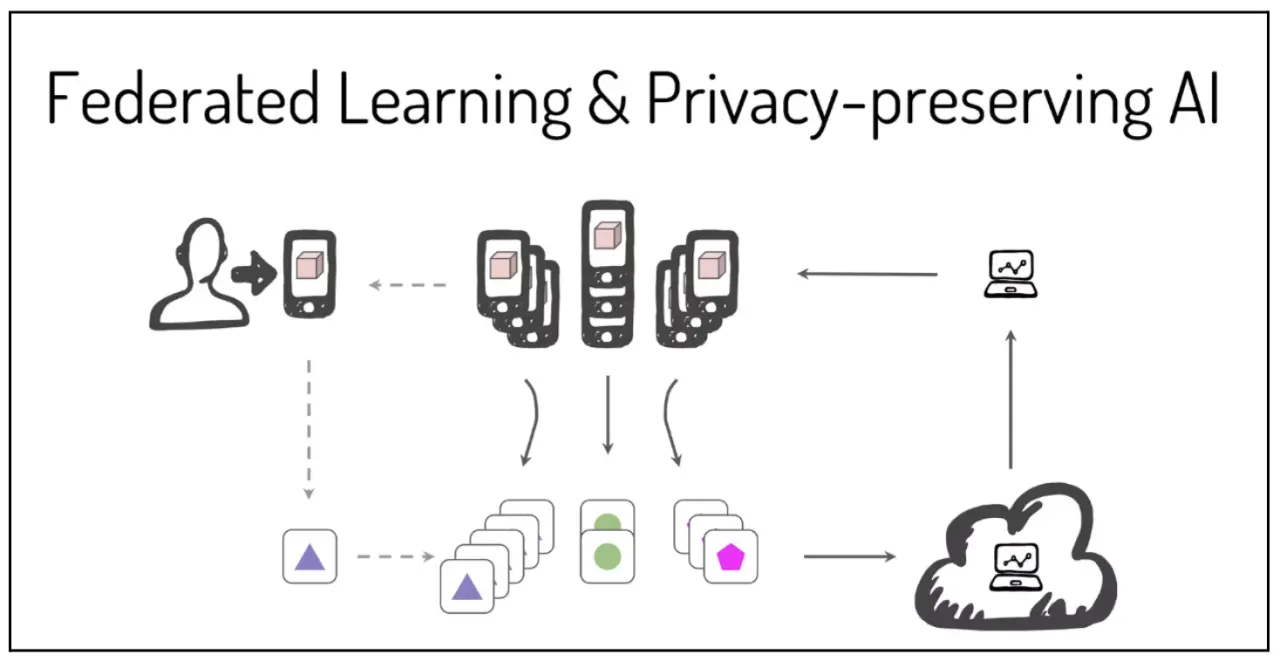
- گوگل: این شرکت از یادگیری فدرال برای بهبود عملکرد سیستم تشخیص گفتار در گوشیهای اندروید استفاده میکند. در این روش، دادههای صوتی هر کاربر در دستگاه محلی پردازش میشود و تنها پارامترهای مدل به سرور مرکزی ارسال میشوند.
- صنعت پزشکی: بیمارستانها و مراکز تحقیقاتی میتوانند از یادگیری فدرال برای توسعه مدلهای تشخیص بیماری استفاده کنند، بدون اینکه دادههای بیمارانی که تحت درمان هستند، منتقل شوند.
- سیستمهای خودران: شرکتهای خودروسازی میتوانند از یادگیری فدرال برای بهبود الگوریتمهای تشخیص محیط در خودروهای خود استفاده کنند، بدون نیاز به دسترسی به دادههای حساس رانندگان.
این مثالها نشان میدهند که یادگیری فدرال نه تنها یک مفهوم نظری است، بلکه در دنیای واقعی نیز کاربردهای گستردهای دارد. با این حال، اجرای موفق این روش نیازمند برنامهریزی دقیق، دانش فنی و توجه به جزئیات است.
آینده یادگیری فدرال
با پیشرفت فناوری و افزایش نیاز به حفظ حریم خصوصی، یادگیری فدرال به یکی از روشهای اصلی در توسعه مدلهای هوش مصنوعی تبدیل خواهد شد. در آینده، میتوان انتظار داشت که:
- الگوریتمهای یادگیری فدرال پیچیدهتر و کارآمدتر شوند.
- کاربردهای جدیدی در حوزههای مختلف مانند مالی، انرژی و حمل و نقل پیدا کنند.
- پلتفرمهای جدیدی برای اجرای سادهتر یادگیری فدرال ارائه شوند.
با توجه به اهمیت این روش، یادگیری مفاهیم اساسی و نکات کاربردی آن میتواند برای توسعهدهندگان و سازمانها بسیار مفید باشد.