در دنیای هوش مصنوعی و یادگیری ماشین، توسعه مدلهای بزرگ و پیچیده یکی از چالشهای اصلی محققان و مهندسان داده است. این مدلها که با حجم عظیم داده و پارامترهای فراوان آموزش میبینند، به ابزارهایی قدرتمند برای حل مشکلات پیچیده تبدیل شدهاند. اما با این حال، استفاده از این مدلها بدون نظارت دقیق میتواند منجر به نتایج غیرمنتظره، خطاهای سیستماتیک یا حتی آسیبهای جدی شود. در این میان، مفهوم یادگیری خودنظارتی به عنوان یک راهکار کلیدی برای بهبود عملکرد و امنیت این مدلها مطرح شده است.
یادگیری خودنظارتی (Self-Monitoring Learning) یک رویکرد نوین در یادگیری ماشین است که به مدلها اجازه میدهد تا عملکرد خود را در حین کار ارزیابی کرده و در صورت نیاز، خود را تنظیم یا اصلاح کنند. این روش برخلاف روشهای سنتی که نیاز به نظارت انسانی مداوم دارند، سعی میکند مدلها بتوانند به صورت خودکار و مستقل، خطاهای خود را شناسایی و برطرف کنند. این ویژگی به ویژه در مدلهای بزرگ که با دادههای پیچیده و متغیر کار میکنند، بسیار ارزشمند است.
چرا یادگیری خودنظارتی در مدلهای بزرگ اهمیت دارد؟
مدلهای بزرگ هوش مصنوعی مانند شبکههای عصبی عمیق یا مدلهای زبان بزرگ (LLMs) به دلیل حجم پارامترهای خود و پیچیدگی دادههای ورودی، مستعد خطاهای مختلفی هستند. این خطاها ممکن است از مشکلاتی مانند:
- بیثباتی در عملکرد: مدلها ممکن است در شرایط جدید یا دادههای نویزدار عملکرد ضعیفی داشته باشند.
- خطاهای سیستماتیک: برخی از مدلها ممکن است به دلیل دادههای ناکافی یا نابرابر، در تشخیص برخی کلاسها یا شرایط دچار مشکل شوند.
- عدم انطباق با تغییرات: مدلها باید بتوانند با تغییرات در دادههای ورودی یا محیط، عملکرد خود را به روز رسانی کنند.
- امنیت و اعتماد: استفاده از مدلهایی که بدون نظارت کار میکنند، میتواند خطرات امنیتی ایجاد کند، به ویژه در کاربردهای حساس مانند پزشکی یا مالی.
در این شرایط، یادگیری خودنظارتی به عنوان یک مکانیسم کنترل داخلی عمل میکند. این روش به مدلها امکان میدهد تا:
- خطاهای خود را شناسایی کنند.
- در صورت نیاز، پارامترهای خود را تنظیم کنند.
- از دادههای جدید برای بهبود عملکرد استفاده کنند.
- به صورت خودکار، عملکرد خود را در شرایط مختلف ارزیابی کنند.
این ویژگیها باعث میشود که مدلهای بزرگ بتوانند به صورت مستقل و با حداقل نیاز به دخالت انسانی، عملکرد خود را بهبود بخشند و در نتیجه، کارایی و اعتمادپذیری آنها افزایش یابد.
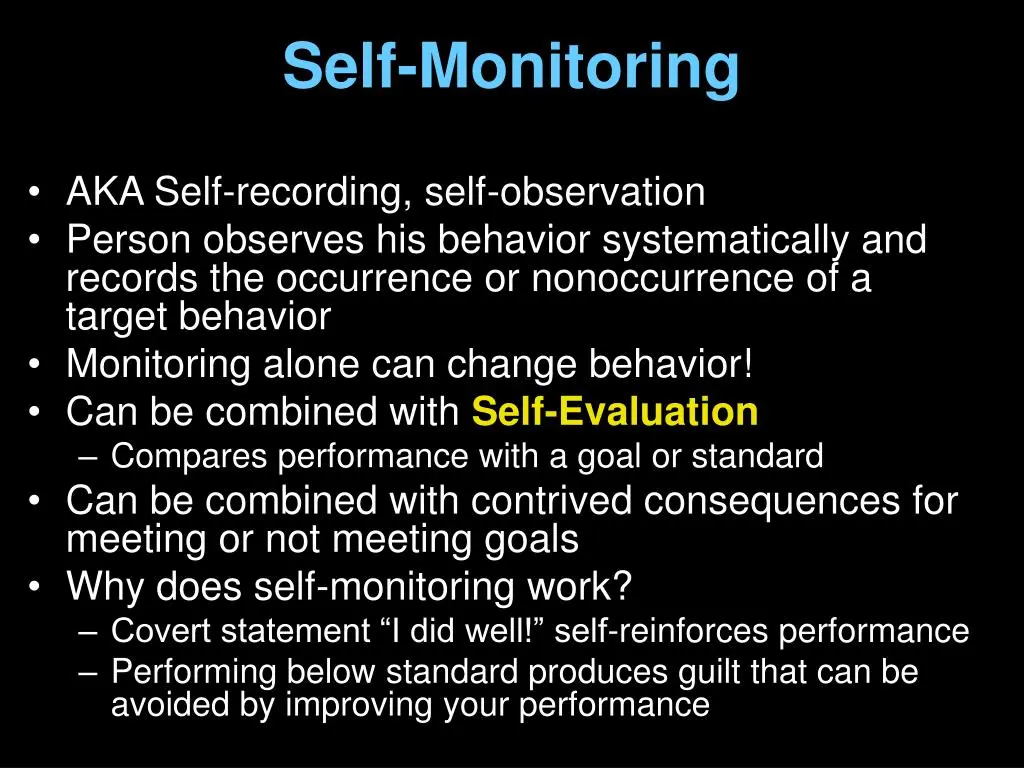
چگونه یادگیری خودنظارتی کار میکند؟
یادگیری خودنظارتی بر اساس اصول زیر کار میکند:
1. ارزیابی خودکار عملکرد
مدلها باید بتوانند عملکرد خود را در زمان واقعی ارزیابی کنند. این ارزیابی میتواند شامل:
- مقایسه خروجیهای مدل با دادههای واقعی یا برچسبهای موجود.
- استفاده از متریکهای عملکرد مانند دقت، recall یا loss function برای تشخیص کاهش عملکرد.
- شناسایی انحرافات در دادههای ورودی که ممکن است نشاندهنده تغییرات محیطی باشد.
2. تشخیص خطا و انحراف
مدلها باید بتوانند خطاهای خود را تشخیص دهند. این تشخیص میتواند به صورت:
- شناسایی خروجیهای غیرمعمول یا غیرمنطقی.
- استفاده از الگوریتمهای تشخیص انحراف برای شناسایی دادههای نویزدار یا غیرطبیعی.
- ارزیابی عدم قطعیت در پیشبینیها (Uncertainty Estimation) برای تشخیص زمانی که مدل با اطمینان کافی کار نمیکند.
3. تنظیم خودکار پارامترها
پس از تشخیص خطا، مدل باید بتواند پارامترهای خود را به صورت خودکار تنظیم کند. این تنظیم میتواند شامل:
- به روزرسانی وزنهای شبکه عصبی با استفاده از دادههای جدید.
- تغییر در معماری مدل برای بهبود عملکرد در شرایط خاص.
- استفاده از روشهای بهینهسازی خودکار مانند reinforcement learning برای بهبود پارامترها.
4. یادگیری پیوسته و انطباقپذیری
یکی از مهمترین ویژگیهای یادگیری خودنظارتی، توانایی یادگیری پیوسته است. مدلها باید بتوانند:
- از دادههای جدید برای به روزرسانی دانش خود استفاده کنند.
- به تغییرات در محیط یا دادههای ورودی انطباق پیدا کنند.
- از تجربیات گذشته برای بهبود عملکرد در شرایط مشابه استفاده کنند.
این ویژگیها باعث میشود که مدلهای بزرگ بتوانند در محیطهای دینامیک و متغیر، عملکرد پایدارتری داشته باشند.
چالشهای یادگیری خودنظارتی
با وجود مزایای فراوان، یادگیری خودنظارتی نیز با چالشهایی همراه است:
- پیچیدگی افزایشیافته: طراحی مکانیزمهای خودنظارتی نیاز به معماریهای پیچیدهتری دارد که توسعه و پیادهسازی آنها زمانبر و هزینهبر است.
- نیاز به دادههای با کیفیت: مدلها برای ارزیابی خودکار نیاز به دادههای آموزشی و ارزیابی با کیفیت دارند. عدم وجود این دادهها میتواند منجر به خطاهای سیستماتیک شود.
- محدودیتهای محاسباتی: برخی از روشهای خودنظارتی مانند به روزرسانی پیوسته پارامترها، نیاز به منابع محاسباتی زیادی دارند.
- امنیت و اعتماد: مدلهای خودنظارتی باید از نظر امنیتی قابل اعتماد باشند، زیرا خطاهای در این مدلها میتواند منجر به آسیبهای جدی شود.
با این حال، با پیشرفتهای اخیر در فناوریهای یادگیری ماشین و افزایش توان محاسباتی، بسیاری از این چالشها در حال حل شدن هستند. استفاده از روشهای نوین مانند یادگیری تقویتی، شبکههای عصبی ژنراتیو و الگوریتمهای بهینهسازی پیشرفته، امکان توسعه مدلهای خودنظارتی با کارایی بالاتر را فراهم آورده است.
کاربردهای عملی یادگیری خودنظارتی
یادگیری خودنظارتی در کاربردهای مختلفی مانند:
- سیستمهای خودران: خودروهای خودران برای بهبود عملکرد و امنیت خود، نیاز به مکانیزمهای خودنظارتی دارند تا بتوانند خطاهای خود را در زمان واقعی تشخیص و برطرف کنند.
- پزشکی: مدلهای تشخیصی در پزشکی برای تشخیص بیماریها و تجویز درمان، باید بتوانند عملکرد خود را در شرایط مختلف ارزیابی کنند.
- مالی: سیستمهای پیشبینی بازار و تشخیص کلاهبرداری باید بتوانند به صورت خودکار، خطاهای خود را شناسایی و اصلاح کنند.
- رباتیک: رباتها برای انجام وظایف پیچیده در محیطهای نامشخص، نیاز به مکانیزمهای خودنظارتی دارند تا بتوانند با تغییرات محیطی سازگار شوند.
- فناوریهای زبان: مدلهای زبان بزرگ مانند چتباتها برای بهبود پاسخهای خود و کاهش خطاهای منطقی، میتوانند از یادگیری خودنظارتی استفاده کنند.
در این کاربردها، یادگیری خودنظارتی به عنوان یک لایه کنترل داخلی عمل میکند که باعث افزایش اعتمادپذیری و کارایی سیستمها میشود.
راهنمای عملی برای پیادهسازی یادگیری خودنظارتی
اگر شما نیز قصد دارید از یادگیری خودنظارتی در پروژههای خود استفاده کنید، میتوانید از راهنمای زیر استفاده کنید:
1. انتخاب معماری مناسب
انتخاب معماری مناسب برای مدل خودنظارتی بسیار مهم است. برخی از معماریهای مناسب شامل:
- شبکههای عصبی بازگشتی (RNN) یا ترانسفورمر برای پردازش دادههای متوالی.
- مدلهای ترکیبی که از شبکههای عصبی و روشهای یادگیری تقویتی استفاده میکنند.
- الگوریتمهای بهینهسازی خودکار مانند Bayesian Optimization برای تنظیم پارامترها.
2. طراحی مکانیزمهای ارزیابی خودکار
برای ارزیابی خودکار عملکرد، میتوانید از:
- متریکهای عملکرد مانند دقت، precision، recall و F1-score استفاده کنید.
- الگوریتمهای تشخیص انحراف مانند Isolation Forest یا Autoencoders برای شناسایی دادههای غیرطبیعی.
- مدلهای عدم قطعیت مانند Monte Carlo Dropout برای ارزیابی اطمینان مدل.
3. پیادهسازی مکانیزمهای تنظیم خودکار
برای تنظیم خودکار پارامترها، میتوانید از:
- روشهای به روزرسانی پیوسته مانند Online Learning استفاده کنید.
- الگوریتمهای یادگیری تقویتی برای بهینهسازی پارامترها در زمان واقعی.
- مکانیزمهای خودکار برای تغییر معماری مدل در صورت نیاز.
4. آزمایش و ارزیابی
پس از پیادهسازی، باید مدل خود را در شرایط مختلف آزمایش کنید:
- استفاده از دادههای تست برای ارزیابی عملکرد مدل.
- شناسایی نقاط ضعف و بهبود آنها.
- ارزیابی کارایی و سرعت مدل در شرایط واقعی.
در این مرحله، میتوانید از ابزارهای مختلف مانند TensorFlow Extended (TFX)، PyTorch Lightning یا MLflow برای مدیریت و ارزیابی مدل استفاده کنید.
برای اطلاعات بیشتر در مورد روشهای نوین در یادگیری ماشین و هوش مصنوعی، میتوانید به مقالات و راهنماهای تخصصی ماشین مگ مراجعه کنید. این منابع میتوانند به شما کمک کنند تا با آخرین پیشرفتها در این زمینه آشنا شوید و پروژههای خود را به بهترین شکل ممکن پیادهسازی کنید.
یادگیری خودنظارتی یک گام مهم در توسعه مدلهای هوشمند و مستقل است. با استفاده از این روش، میتوانیم مدلهای بزرگتر و پیچیدهتری را توسعه دهیم که به صورت خودکار عملکرد خود را بهبود میبخشند و در نتیجه، اعتمادپذیری و کارایی آنها افزایش یابد. این رویکرد نه تنها در پروژههای تحقیقاتی، بلکه در کاربردهای عملی نیز بسیار ارزشمند است و میتواند آینده هوش مصنوعی را شکل دهد.