در دنیای امروزی که هوش مصنوعی به یکی از مهمترین ابزاری برای حل مشکلات پیچیده تبدیل شده است، یکی از مراحل حیاتی اما کمتر شناختهشده در آموزش مدلهای هوش مصنوعی، برچسبگذاری دادهها است. این فرایند که گاهی به عنوان «انetikتگذاری دادهها» نیز شناخته میشود، به معنای افزودن متادیتا یا برچسبهای مشخص به دادههای خام است تا مدلهای یادگیری ماشین بتوانند از آنها برای یادگیری و پیشبینی استفاده کنند. اما چرا این مرحله به این اندازه اهمیت دارد؟ و چگونه میتوانیم دادههای خود را برای آموزش هوش مصنوعی آماده کنیم؟ در این راهنما کامل، به بررسی مفاهیم اساسی، اهمیت، روشها و چالشهای برچسبگذاری دادهها میپردازیم.
برچسبگذاری دادهها چیست؟
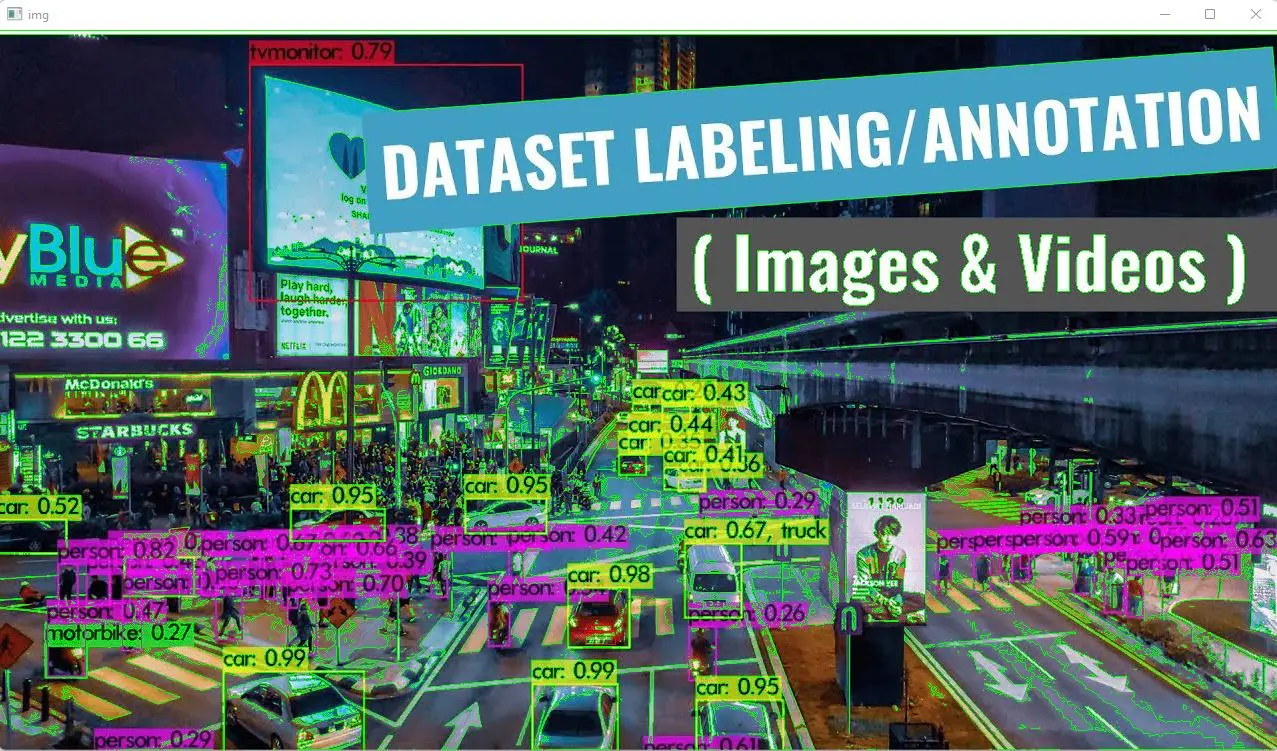
برچسبگذاری دادهها فرایندی است که در آن دادههای خام مانند تصاویر، متنها، صداها یا ویدئوها با برچسبهای مشخصی همراه میشوند. این برچسبها میتوانند شامل دستهبندیها، توضیحات، مختصات، یا حتی احساسات باشند. برای مثال، در یک مجموعه داده تصاویر، هر تصویر ممکن است با برچسب «گربه»، «سگ»، یا «پارو» همراه شود تا مدل یادگیری ماشین بتواند تفاوت بین آنها را تشخیص دهد.
این فرایند در واقع به مدلهای هوش مصنوعی کمک میکند تا یاد بگیرند که چگونه دادههای جدید را تفسیر کنند. بدون برچسبگذاری صحیح، مدلها نمیتوانند بین دادههای مختلف تمایز قائل شوند و در نتیجه عملکرد ضعیفی خواهند داشت.
چرا برچسبگذاری دادهها برای آموزش هوش مصنوعی ضروری است؟
هوش مصنوعی به دادههای با کیفیت بالا نیاز دارد تا بتواند الگوها و روابط بین دادهها را شناسایی کند. برچسبگذاری دادهها به عنوان یک قدم اساسی در این مسیر عمل میکند. در ادامه به چند دلیل مهم برای اهمیت این فرایند میپردازیم:
- دقت مدل: دادههای برچسبگذاریشده به مدلها کمک میکنند تا الگوها را با دقت بیشتری شناسایی کنند. برای مثال، یک مدل تشخیص چهره بدون دادههای برچسبگذاریشده نمیتواند تفاوت بین دو چهره مشابه را تشخیص دهد.
- یادگیری نظارتشده: بیشتر مدلهای هوش مصنوعی از روشهای یادگیری نظارتشده استفاده میکنند که به دادههای برچسبگذاریشده نیاز دارند. بدون این برچسبها، مدلها نمیتوانند از دادههای آموزشی استفاده کنند.
- کاهش خطا: دادههای نامناسب یا نادرست میتوانند منجر به خطاهای جدی در مدل شوند. برچسبگذاری دقیق کمک میکند تا این خطاها کاهش یابند.
- کارایی: دادههای سازمانیافته و برچسبگذاریشده به مدلها کمک میکنند تا سریعتر و با کارایی بیشتری یاد بگیرند.
چگونه دادهها را برچسبگذاری کنیم؟
برچسبگذاری دادهها میتواند به روشهای مختلفی انجام شود، بسته به نوع دادهها و نیازهای پروژه. در این بخش به برخی از روشهای رایج برای برچسبگذاری دادهها میپردازیم:
برچسبگذاری دستی
در این روش، انسانها دادهها را به صورت دستی برچسبگذاری میکنند. این روش دقیقترین روش است، اما زمانبر و گرانقیمت است. برای مثال، در پروژههای تشخیص تصویر، افراد ممکن است هر تصویر را به دستهبندیهای مختلفی مانند «گربه»، «سگ»، یا «پارو» اختصاص دهند.
برچسبگذاری خودکار
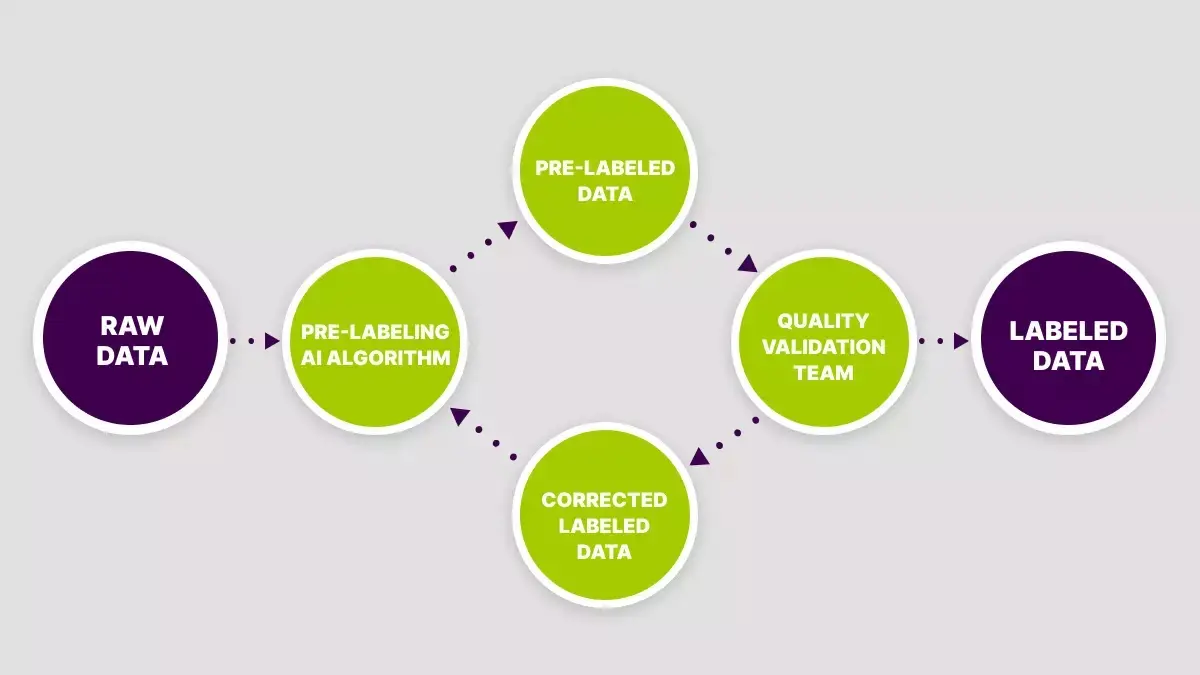
در این روش، از الگوریتمها و مدلهای پیشتrained استفاده میشود تا دادهها را به صورت خودکار برچسبگذاری کنند. این روش سریعتر از روش دستی است، اما ممکن است دقت کمتری داشته باشد و نیاز به بررسی و تصحیح دستی داشته باشد.
برچسبگذاری نیمهاتوماتیک
این روش ترکیبی از روشهای دستی و خودکار است. در این روش، ابتدا دادهها به صورت خودکار برچسبگذاری میشوند و سپس توسط انسانها بررسی و تصحیح میشوند. این روش میتواند زمان و هزینه را کاهش دهد، در حالی که دقت را نیز حفظ میکند.
ابزارهای برچسبگذاری داده
برای انجام این فرایند، از ابزارهای مختلفی استفاده میشود. برخی از این ابزارها شامل:
- LabelImg: برای برچسبگذاری تصاویر در پروژههای تشخیص شی.
- Prodigy: برای برچسبگذاری متن و دادههای ساختاریافته.
- CVAT (Computer Vision Annotation Tool): برای برچسبگذاری تصاویر و ویدئوها.
- Amazon SageMaker Ground Truth: برای برچسبگذاری دادهها در مقیاس بزرگ.
چالشهای برچسبگذاری دادهها
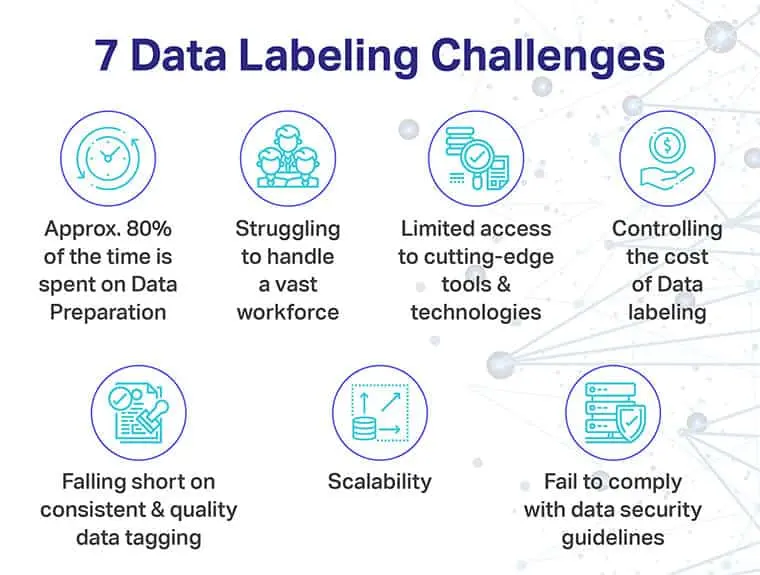
در حالی که برچسبگذاری دادهها بسیار مهم است، این فرایند با چالشهای متعددی همراه است:
- زمانبر بودن: برچسبگذاری دستی دادهها میتواند بسیار زمانبر باشد، به خصوص در پروژههای بزرگ.
- هزینه: استخدام افراد برای برچسبگذاری دادهها میتواند هزینهبر باشد.
- دقت: برچسبگذاری نادرست میتواند منجر به مدلهای با عملکرد ضعیف شود.
- مقیاسپذیری: برچسبگذاری دادهها در مقیاس بزرگ میتواند چالشبرانگیز باشد.
- تنوع دادهها: دادههای متنوع ممکن است نیاز به برچسبگذاریهای مختلف داشته باشند که این خود میتواند پیچیده باشد.
برای مقابله با این چالشها، میتوان از روشهای نیمهاتوماتیک، استفاده از ابزارهای مناسب و همچنین تقسیم کار بین تیمهای مختلف استفاده کرد.
برچسبگذاری دادهها در پروژههای مختلف هوش مصنوعی
برچسبگذاری دادهها در پروژههای مختلف هوش مصنوعی کاربردهای متفاوتی دارد. در این بخش به برخی از این کاربردها میپردازیم:
دادههای تصویری
در پروژههای تشخیص تصویر، دادهها معمولاً با برچسبهای دستهبندی یا مختصات شیها همراه میشوند. برای مثال، در پروژههای خودران، تصاویر ممکن است با برچسبهای «پیشروی»، «توقف»، یا «چپچرخی» همراه شوند.
دادههای متنی
در پروژههای پردازش زبان طبیعی (NLP)، دادههای متنی ممکن است با برچسبهای احساسات، موضوعات، یا دستهبندیهای مختلف همراه شوند. برای مثال، در تحلیل احساسات، جملهها ممکن است با برچسبهای «مثبت»، «منفی»، یا «neutral» همراه شوند.
دادههای صوتی
در پروژههای پردازش زبان گفتاری، دادههای صوتی ممکن است با برچسبهای متن مرتبط یا دستهبندیهای مختلف همراه شوند. برای مثال، در سیستمهای تشخیص گفتار، صداها ممکن است با متن مربوطه برچسبگذاری شوند.
دادههای ویدئویی
در پروژههای پردازش ویدئو، دادهها ممکن است با برچسبهای مختلفی مانند «حرکت»، «تصویر ثابت»، یا «دستهبندی شی» همراه شوند. این برچسبها به مدلها کمک میکنند تا رفتارهای مختلف را تشخیص دهند.
نکات مهم برای برچسبگذاری دادهها
برای انجام یک برچسبگذاری داده موفق، باید به نکات زیر توجه کرد:
- دقت: برچسبگذاری باید دقیق باشد تا مدلهای هوش مصنوعی بتوانند از دادهها یاد بگیرند.
- یکنواختی: برچسبگذاری باید یکنواخت باشد تا مدلها بتوانند الگوها را به درستی شناسایی کنند.
- کمیت: دادههای کافی برای آموزش مدلها لازم است. دادههای کم ممکن است منجر به مدلهای ضعیف شود.
- تنوع: دادهها باید متنوع باشند تا مدلها بتوانند در شرایط مختلف عملکرد خوبی داشته باشند.
- دستورالعملهای واضح: دستورالعملهای دقیق برای برچسبگذاری باید به تیمهای برچسبگذاری داده ارائه شود.
در نهایت، برچسبگذاری دادهها یک فرایند پیچیده اما ضروری است که میتواند تأثیر زیادی بر عملکرد مدلهای هوش مصنوعی داشته باشد. با استفاده از روشهای مناسب و ابزارهای مناسب، میتوان این فرایند را بهینه کرد و دادههای با کیفیت بالایی برای آموزش مدلها فراهم آورد.
برای اطلاعات بیشتر در مورد ابزارها و روشهای مختلف برچسبگذاری دادهها، میتوانید به مقالات مرتبط در ماشین مگ مراجعه کنید.