هوش مصنوعی در سالهای اخیر به یکی از مهمترین ابزارهای فناوری تبدیل شده است که در بسیاری از حوزهها از جمله تشخیص تصویر، پردازش زبان طبیعی، تشخیص صدا و حتی تصمیمگیریهای خودکار کاربرد دارد. اما با پیشرفت این فناوری، خطرات جدیدی نیز به وجود آمده است. یکی از این خطرات، حمله خصمانه به هوش مصنوعی است که میتواند عملکرد مدلهای یادگیری ماشین را مختل کرده و نتایج نادرستی تولید کند. در این مقاله به بررسی مفهوم حمله خصمانه، انواع آن، چگونگی تأثیرگذاری بر مدلها و نکات کاربردی برای مقابله با این تهدید میپردازیم.
چه چیزی حمله خصمانه به هوش مصنوعی است؟
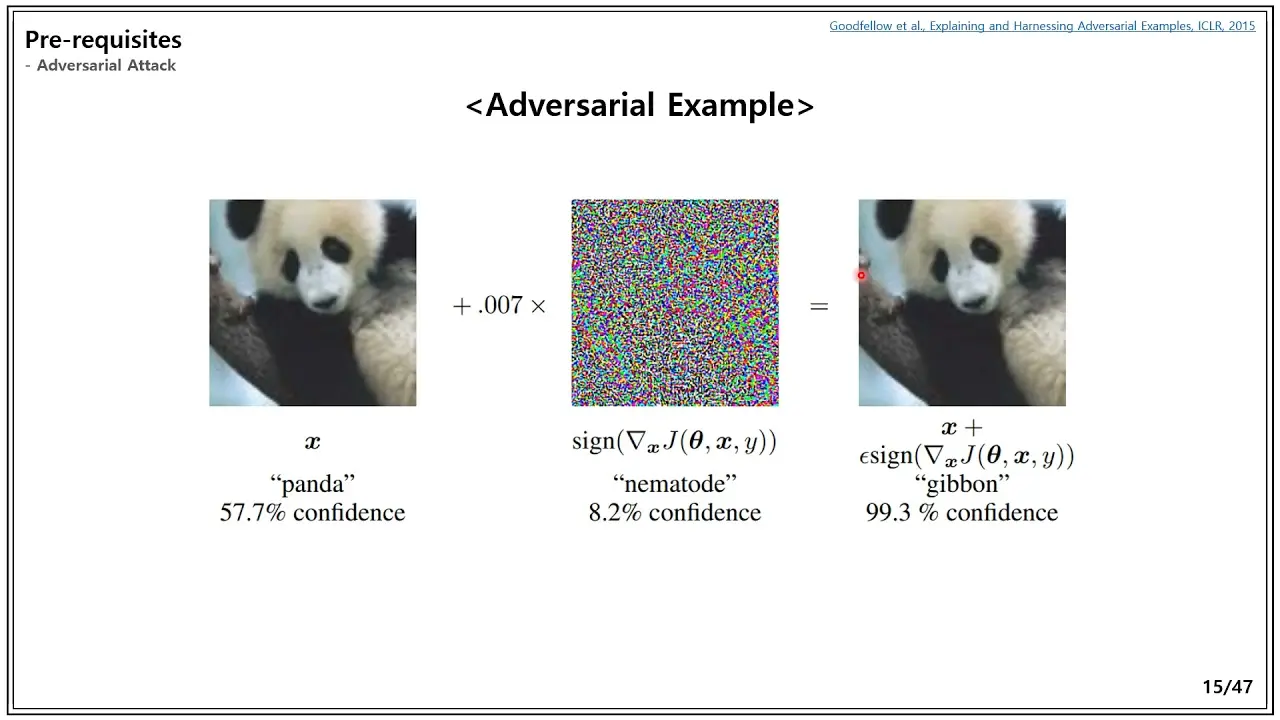
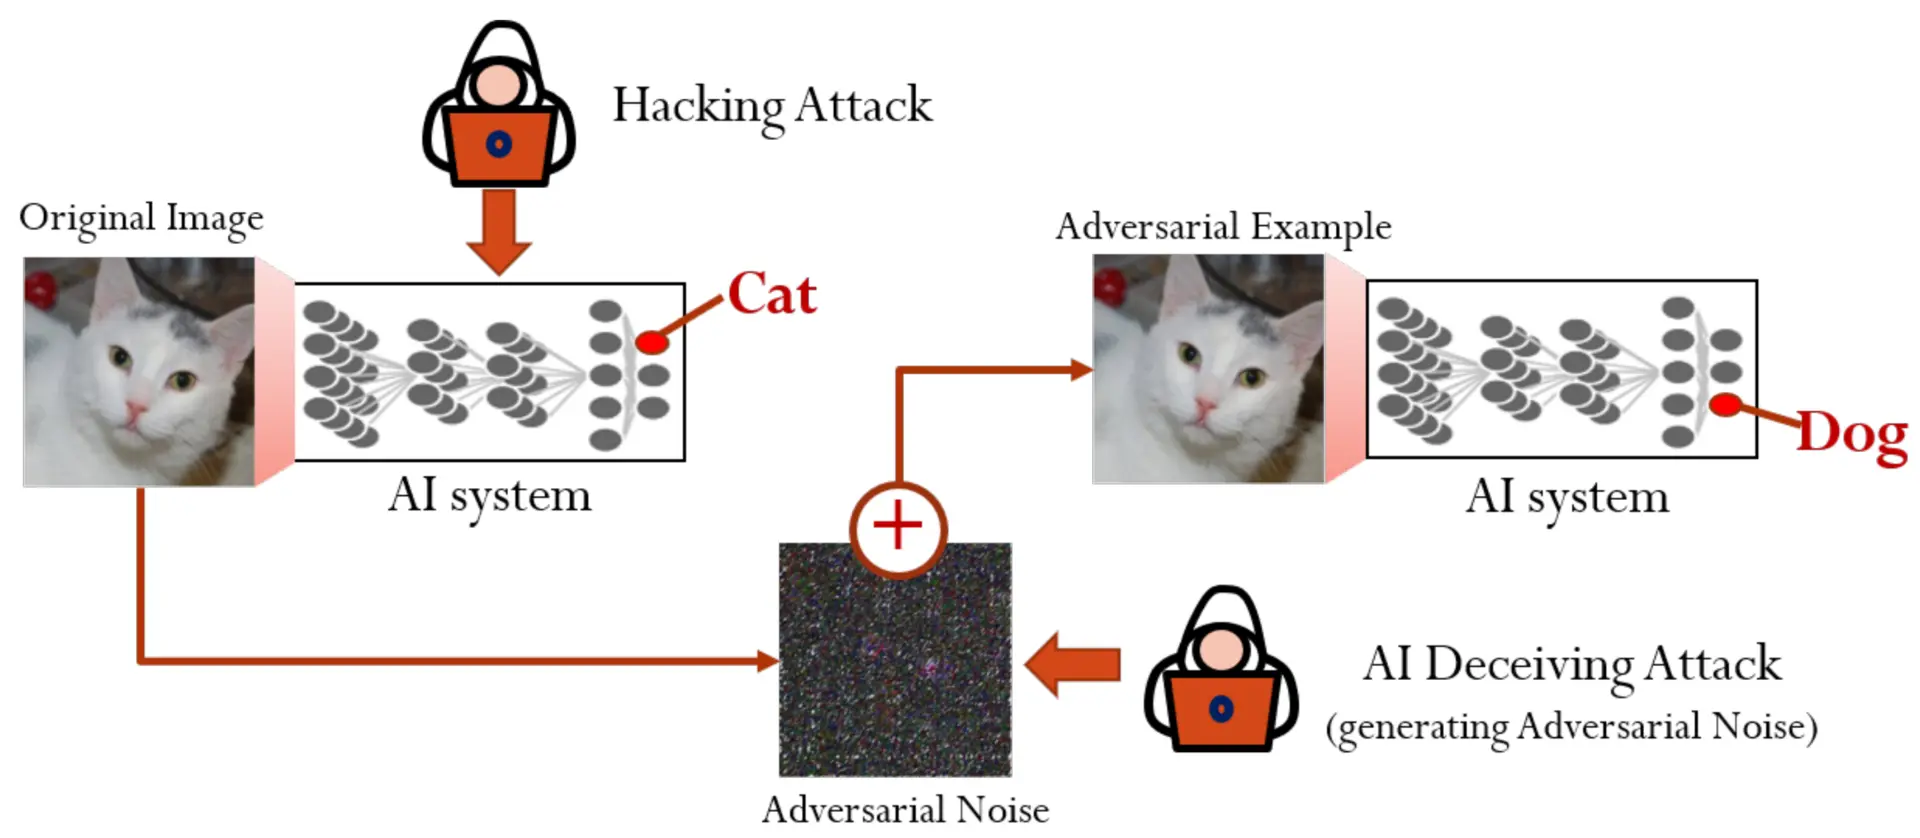
حمله خصمانه به هوش مصنوعی (Adversarial Attack) یک روش است که در آن دادههای ورودی به مدل یادگیری ماشین به گونهای تغییر مییابند که مدل نتایج نادرستی تولید کند. این تغییرات معمولاً برای چشم انسان غیرقابل تشخیص هستند، اما برای الگوریتمها میتوانند بسیار تأثیرگذار باشند. هدف از این حملات فریب دادن مدل برای تولید پاسخهای نادرست یا حتی تغییر رفتار آن در شرایط خاص است.
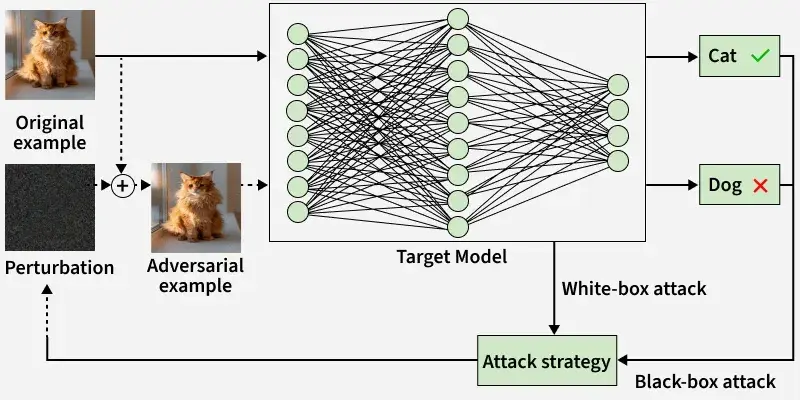
این نوع حملات میتواند در سیستمهای تشخیص چهره، تشخیص اشیاء، تشخیص امنیتی و حتی خودروهای خودران تأثیرگذار باشد. برای مثال، یک تصویر معمولی از یک گربه ممکن است با تغییرات جزئی در پیکسلها به گونهای تغییر کند که مدل تشخیص تصویر آن را یک گربه تشخیص ندهد و به جای آن یک سگ یا حتی یک شیء دیگر تشخیص دهد.
چگونه تصویر میتواند مدل را فریب دهد؟
یکی از روشهای رایج حمله خصمانه، تغییرات جزئی در دادههای ورودی است. این تغییرات ممکن است شامل تغییرات در رنگ، نور، یا حتی ساختار پیکسلها باشد. برای مثال، در یک تصویر از یک ترافیکلایت، تغییرات جزئی در پیکسلها میتواند باعث شود که مدل تشخیص تصویر آن را به اشتباه یک چراغ سبز تشخیص دهد، در حالی که در واقع قرمز است.
این تغییرات معمولاً با استفاده از تکنیکهایی مانند FGSM (Fast Gradient Sign Method) یا PGD (Projected Gradient Descent) اعمال میشوند. در این روشها، الگوریتم با استفاده از گرادیانهای تابع هزینه، تغییرات کوچک اما مؤثر را در دادههای ورودی ایجاد میکند تا مدل را فریب دهد.
انواع حمله خصمانه به هوش مصنوعی
حملههای خصمانه به هوش مصنوعی میتوانند به چند دسته تقسیم شوند:
- حمله بر اساس داده ورودی: در این نوع حمله، دادههای ورودی به مدل تغییر مییابند. برای مثال، تغییرات جزئی در یک تصویر یا صدا که باعث میشود مدل تشخیص اشتباه کند.
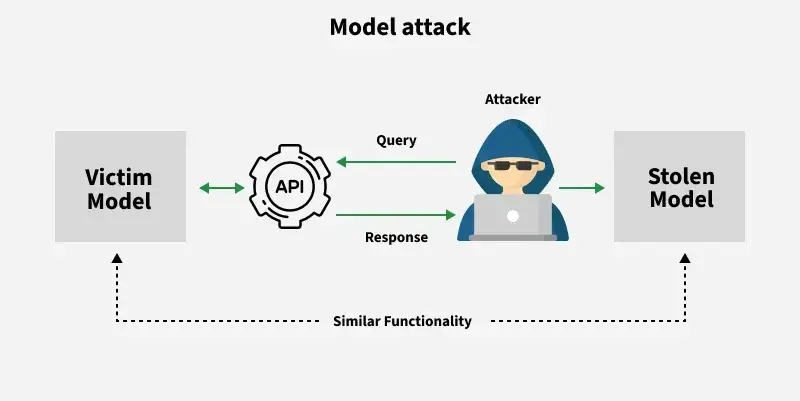
- حمله بر اساس مدل: در این روش، خود مدل یادگیری ماشین هدف قرار میگیرد. برای مثال، تغییر پارامترهای مدل یا فریب دادن آن با دادههای خاص.
- حمله فیزیکی: این نوع حمله در دنیای واقعی رخ میدهد. برای مثال، چاپ یک تصویر فریبنده و نمایش آن در برابر یک دوربین تشخیص چهره.
- حمله بر اساس دادههای آموزشی: در این روش، دادههای آموزشی مدل به گونهای تغییر مییابند که مدل در تشخیص اشتباه شود. برای مثال، اضافه کردن دادههای نادرست به مجموعه دادههای آموزشی.
هر یک از این انواع حملات میتواند در زمینههای مختلف از جمله امنیت سایبری، خودروهای خودران و تشخیص پزشکی تأثیرگذار باشد.
چگونه میتوان مدلها را در برابر حملات خصمانه مقاوم کرد؟
برای مقابله با حملات خصمانه، روشهای مختلفی وجود دارد که میتوان از آنها استفاده کرد:
- تولید دادههای آموزشی با کیفیت: استفاده از دادههای آموزشی متنوع و با کیفیت میتواند کمک کند تا مدل در برابر تغییرات جزئی در دادههای ورودی مقاومتر باشد.
- استفاده از تکنیکهای دفاعی: روشهایی مانند اضافه کردن نویز به دادهها، استفاده از مدلهای عمیقتر یا حتی استفاده از شبکههای عصبی مقیاسپذیر میتواند در افزایش مقاومت مدل مؤثر باشد.
- ارزیابی مداوم: ارزیابی مداوم مدل با دادههای مختلف و شرایط مختلف میتواند کمک کند تا نقاط ضعف مدل شناسایی و اصلاح شوند.
- استفاده از روشهای تشخیص حمله: الگوریتمهایی که میتوانند حملات خصمانه را تشخیص دهند، میتوانند در زمان واقعی به مدل هشدار دهند و از تأثیرگذاری حملات جلوگیری کنند.
نکات کاربردی برای توسعهدهندگان و کاربران
اگر شما یک توسعهدهنده یا کاربر هوش مصنوعی هستید، باید به نکات زیر توجه کنید:
- آگاهی از خطرات: آگاهی از وجود حملات خصمانه و روشهای آنها میتواند کمک کند تا در طراحی و استفاده از مدلها دقت بیشتری داشته باشید.
- استفاده از دادههای واقعی: استفاده از دادههای واقعی و متنوع در آموزش مدل میتواند کمک کند تا مدل در برابر تغییرات جزئی مقاومتر باشد.
- بازبینی مداوم: بازبینی مداوم مدل و ارزیابی عملکرد آن در شرایط مختلف میتواند از تأثیرگذاری حملات جلوگیری کند.
- استفاده از ابزارهای امنیتی: استفاده از ابزارهای امنیتی و تکنیکهای دفاعی میتواند در افزایش امنیت مدل مؤثر باشد.
در دنیای امروز که هوش مصنوعی در بسیاری از زمینهها کاربرد دارد، آگاهی از خطرات و روشهای مقابله با آنها بسیار مهم است. با توجه به این نکات، میتوانید از مدلهای هوش مصنوعی خود با اطمینان بیشتری استفاده کنید.
برای اطلاعات بیشتر در مورد آخرین دستاوردهای هوش مصنوعی و روشهای بهبود امنیت مدلها، میتوانید به مقالات مرتبط در ماشین مگ مراجعه کنید.