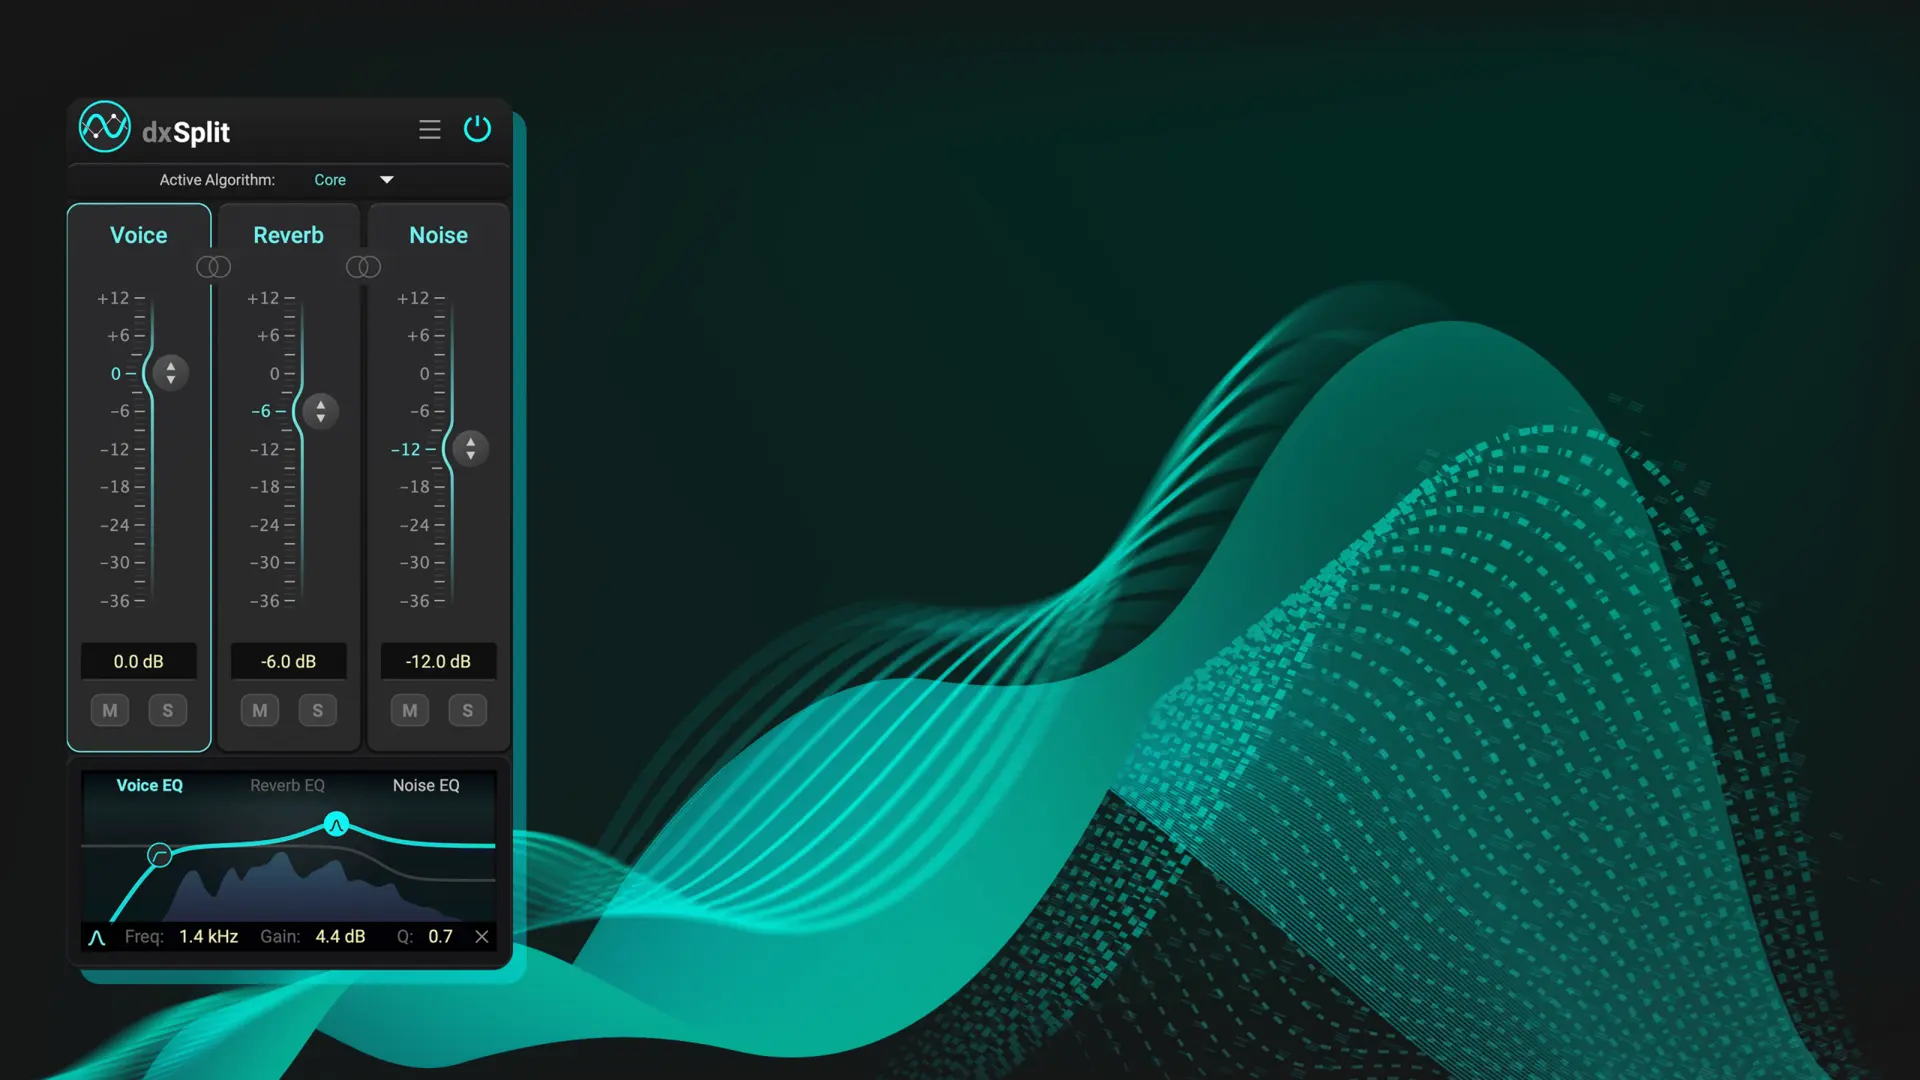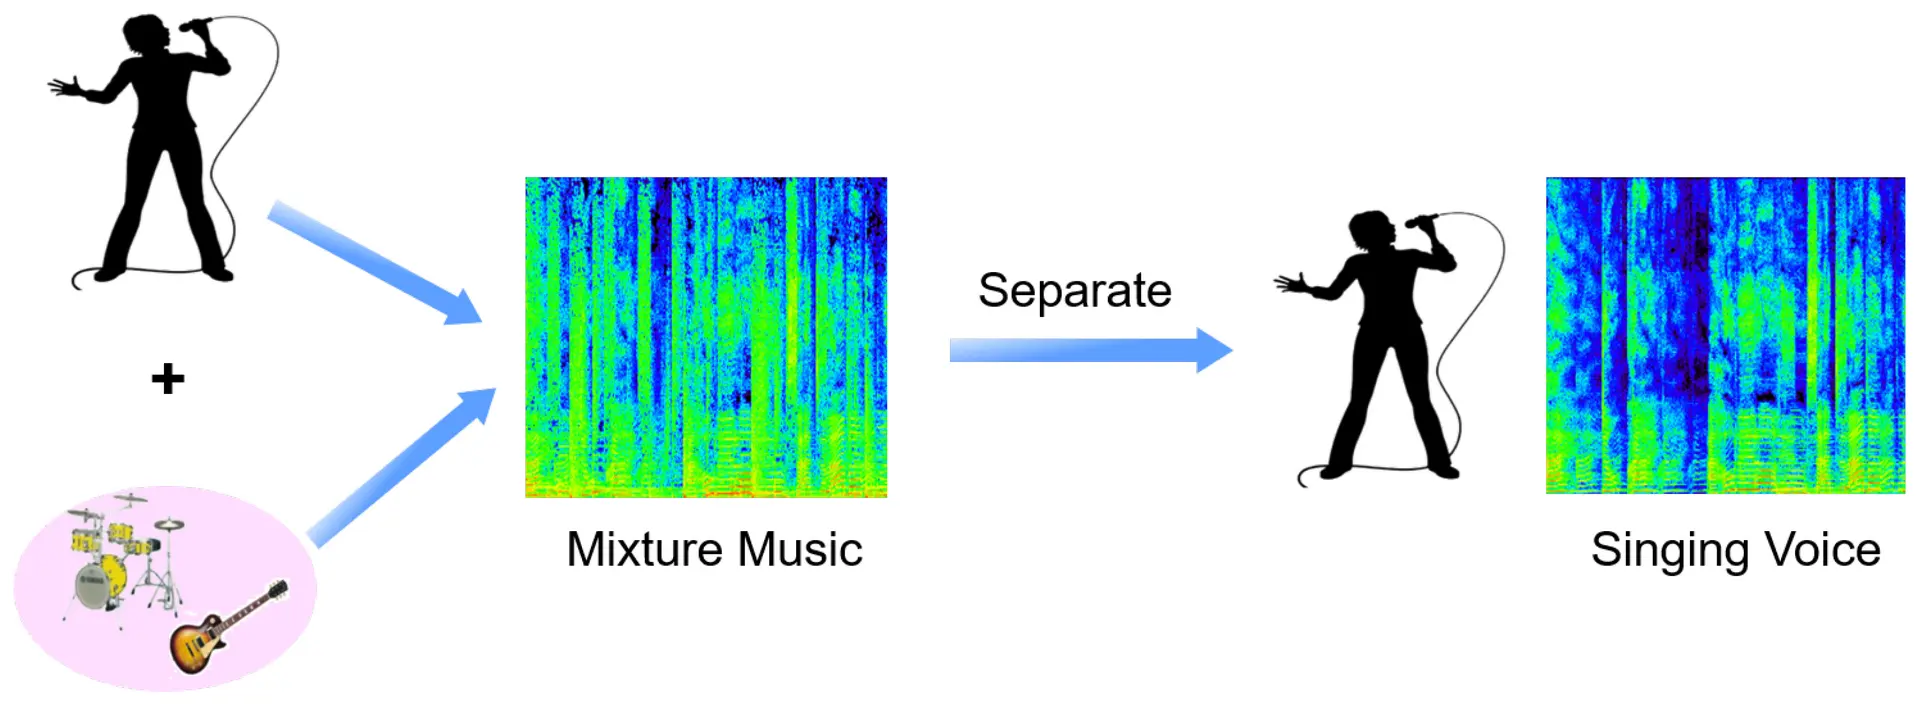
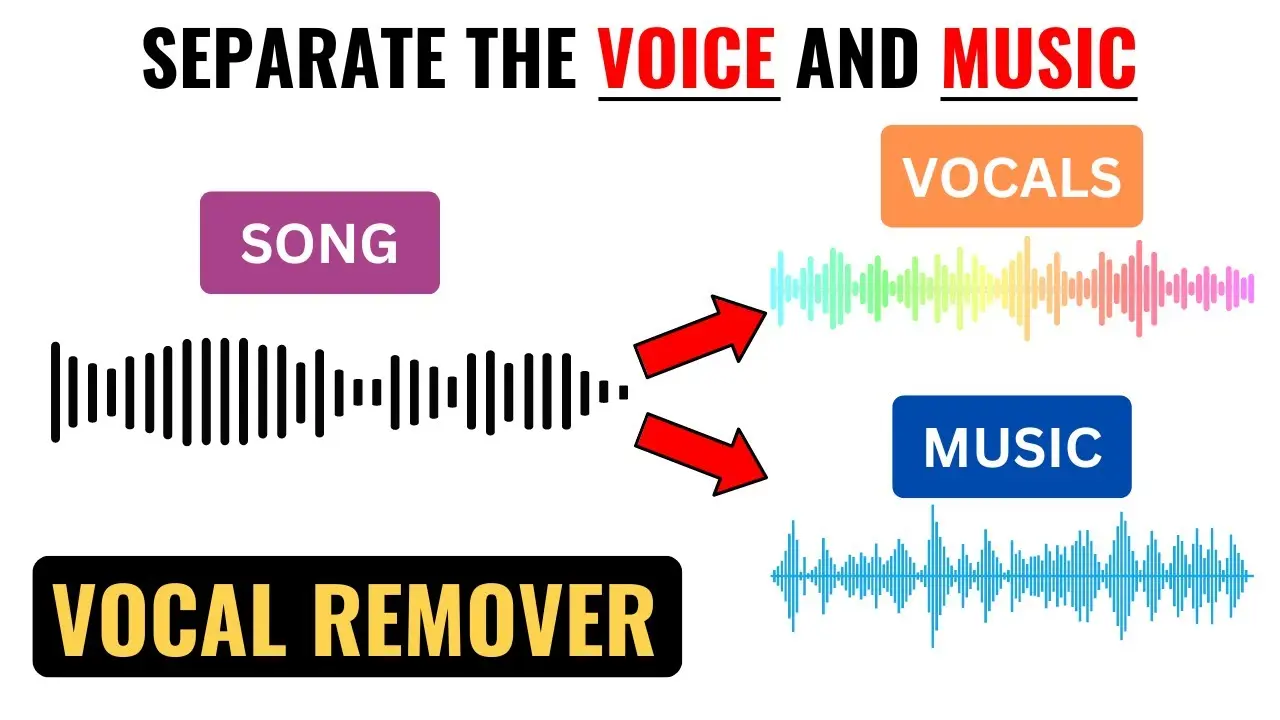
جداسازی صدای خواننده از موسیقی یکی از کاربردهای جالب و کاربردی هوش مصنوعی در صنعت موسیقی است. این تکنولوژی به شما امکان میدهد تا صدای خواننده را از بکگراند موسیقی جدا کرده و برای استفاده در پروژههای مختلف مانند ساخت ریمیکس، ایجاد کاور جدید یا حتی بهبود کیفیت صدا استفاده کنید. اما چگونه این کار انجام میشود؟ در این راهنما به طور ساده و عملی به توضیح روشهای جداسازی صدای خواننده با استفاده از هوش مصنوعی میپردازیم.
چرا جداسازی صدای خواننده مهم است؟
جداسازی صدای خواننده از موسیقی در صنایع مختلف کاربرد دارد. برای مثال:
- پردازش و بهبود کیفیت صدا در استودیوهای ضبط
- ایجاد ریمیکس یا تغییرات روی آهنگهای موجود
- تولید موسیقی بدون نیاز به ضبط مجدد خواننده
- تحلیل و بررسی صدای خواننده برای آموزش یا بهبود تکنیک خوانندگی
با پیشرفت هوش مصنوعی، این فرآیند به طور قابل توجهی سادهتر شده و حتی افراد غیرمتخصص نیز میتوانند از آن استفاده کنند.
روشهای جداسازی صدای خواننده با هوش مصنوعی
در حال حاضر چندین روش برای جداسازی صدای خواننده با استفاده از هوش مصنوعی وجود دارد. دو روش اصلی شامل استفاده از الگوریتمهای یادگیری عمیق و مدلهای پیشرفته پردازش سیگنال است. در ادامه به معرفی برخی از این روشها میپردازیم:
۱. استفاده از مدلهای یادگیری عمیق
مدلهای یادگیری عمیق مانند شبکههای عصبی عمیق (Deep Neural Networks) و به ویژه شبکههای خودکارساز (Autoencoders) و مدلهای مبتنی بر تبدیل فوریه (STFT) توانایی جداسازی صدای خواننده از موسیقی را دارند. این مدلها با آموزش بر روی دادههای بزرگ موسیقی، میتوانند صدای خواننده را از بکگراند جدا کنند.
یکی از معروفترین ابزارهای مبتنی بر این روش، Spleeter است که توسط اسپاتیفای توسعه یافته و به صورت رایگان در دسترس است. این ابزار با استفاده از شبکههای عصبی، میتواند صدای خواننده را از موسیقی جدا کند و فایلهای جداگانه برای خواننده و بکگراند تولید کند.
۲. استفاده از نرمافزارهای تخصصی
برخی نرمافزارها و پلتفرمهای آنلاین نیز امکان جداسازی صدای خواننده را با استفاده از هوش مصنوعی فراهم کردهاند. این نرمافزارها معمولاً رابط کاربری سادهای دارند و نیازی به دانش فنی پیشرفته ندارند. برخی از این ابزارها عبارتند از:
- LALAL.AI
- Photoshop (با استفاده از افزونههای هوش مصنوعی)
- Adobe Audition (با استفاده از ابزارهای جداسازی)
این ابزارها معمولاً نیاز به پرداخت هزینه دارند، اما برخی از آنها نسخههای آزمایشی رایگان نیز ارائه میدهند.
۳. استفاده از کتابخانههای برنامهنویسی
اگر شما برنامهنویس هستید یا علاقهمند به کار با کد هستید، میتوانید از کتابخانههای مختلفی مانند Librosa، TensorFlow یا PyTorch برای جداسازی صدای خواننده استفاده کنید. این کتابخانهها امکانات پیشرفتهای برای پردازش سیگنال صوتی و استفاده از مدلهای یادگیری عمیق را فراهم میکنند.
برای شروع، میتوانید از نمونه کدهای موجود در این کتابخانهها استفاده کنید و با تغییر پارامترها، نتایج بهتری کسب کنید.
چگونه میتوانید از این تکنولوژی استفاده کنید؟
برای جداسازی صدای خواننده با استفاده از هوش مصنوعی، مراحل زیر را دنبال کنید:
- انتخاب ابزار مناسب: بسته به نیاز خود، میتوانید از ابزارهای آنلاین، نرمافزارهای تخصصی یا کتابخانههای برنامهنویسی استفاده کنید.
- آپلود فایل: فایل موسیقی خود را به پلتفرم یا نرمافزار آپلود کنید.
- انتظار برای پردازش: هوش مصنوعی فایل را پردازش کرده و صدای خواننده را از بکگراند جدا میکند.
- دانلود فایلهای جداگانه: پس از پردازش، میتوانید فایلهای جداگانه برای خواننده و بکگراند دانلود کنید.
در برخی موارد، ممکن است نیاز به تنظیمات پیشرفتهتری داشته باشید، اما برای کارهای ساده، این مراحل کافی است.
مزایا و محدودیتهای جداسازی صدای خواننده با هوش مصنوعی
استفاده از هوش مصنوعی برای جداسازی صدای خواننده مزایای بسیاری دارد، اما همچنین محدودیتهایی نیز وجود دارد:
مزایا:
- سادهسازی فرآیند جداسازی صدا
- کاهش هزینههای تولید موسیقی
- امکان استفاده در پروژههای مختلف مانند ریمیکس و کاور
- دقت بالا در جداسازی صدای خواننده از بکگراند
محدودیتها:
- نیاز به سختافزار قوی برای پردازش فایلهای بزرگ
- در برخی موارد، کیفیت صدای جداسازی شده ممکن است کامل نباشد
- بعضی از ابزارها نیاز به پرداخت هزینه دارند
- درصداهای پیچیده یا با کیفیت پایین، دقت جداسازی ممکن است کاهش یابد
با این حال، با پیشرفت تکنولوژی، این محدودیتها در حال کاهش هستند و در آینده نزدیک، امکان جداسازی صدای خواننده با کیفیت بالاتر و با هزینه کمتر فراهم خواهد شد.
نکات مهم برای بهبود کیفیت جداسازی
برای دستیابی به بهترین نتایج در جداسازی صدای خواننده، میتوانید نکات زیر را در نظر بگیرید:
- استفاده از فایلهای با کیفیت بالا: فایلهای با فرکانس نمونهبرداری بالاتر و بیتی بیشتر، نتایج بهتری ارائه میدهند.
- تنظیم پارامترهای نرمافزار: در برخی ابزارها، امکان تنظیم پارامترهای مختلف مانند حساسیت جداسازی یا کیفیت خروجی وجود دارد.
- پردازش در محیطهای آرام: صدای محیطی مانند صدای ترافیک یا صدای پشت صحنه میتواند کیفیت جداسازی را کاهش دهد.
- استفاده از ابزارهای پیشرفته: اگر نیاز به دقت بالا دارید، میتوانید از ابزارهای پیشرفتهتر یا مدلهای آموزش دیده استفاده کنید.
با توجه به این نکات، میتوانید کیفیت جداسازی صدای خواننده را بهبود بخشیده و نتایج بهتری کسب کنید.
آینده جداسازی صدای خواننده با هوش مصنوعی
با پیشرفت هوش مصنوعی و یادگیری عمیق، تکنولوژی جداسازی صدای خواننده نیز در حال تکامل است. در آینده، میتوانیم شاهد بهبود دقت، کاهش هزینهها و افزایش سرعت پردازش باشیم. همچنین، امکان استفاده از این تکنولوژی در زمینههای جدید مانند تولید موسیقی خودکار یا بهبود کیفیت صدا در زمان واقعی نیز فراهم خواهد شد.
اگر شما نیز علاقهمند به استفاده از این تکنولوژی هستید، میتوانید از منابع آموزشی مختلف برای یادگیری بیشتر استفاده کنید. برای مثال، در ماشین مگ میتوانید مقالات و راهنماهای مفیدی در مورد هوش مصنوعی و کاربردهای آن در صنعت موسیقی پیدا کنید.