تکنولوژی شبیهسازی صدای انسان با هوش مصنوعی در سالهای اخیر به یکی از حوزههای پرکاربرد و جالب توجه تبدیل شده است. این فناوری نه تنها در تولید محتوای صوتی برای بازیها، فیلمها و برنامههای تلویزیونی کاربرد دارد، بلکه در خدمات مشتری، خواندن کتاب صوتی، و حتی در کاربردهای پزشکی و آموزشی نیز به کار میرود. اما چگونه این فرایند انجام میشود؟ چه نکاتی باید در استفاده از آن رعایت کرد؟ و چه اشتباهاتی باید از آن اجتناب کرد؟ در این مقاله به بررسی این موضوعات میپردازیم.
اصول پایه شبیهسازی صدای انسان با هوش مصنوعی
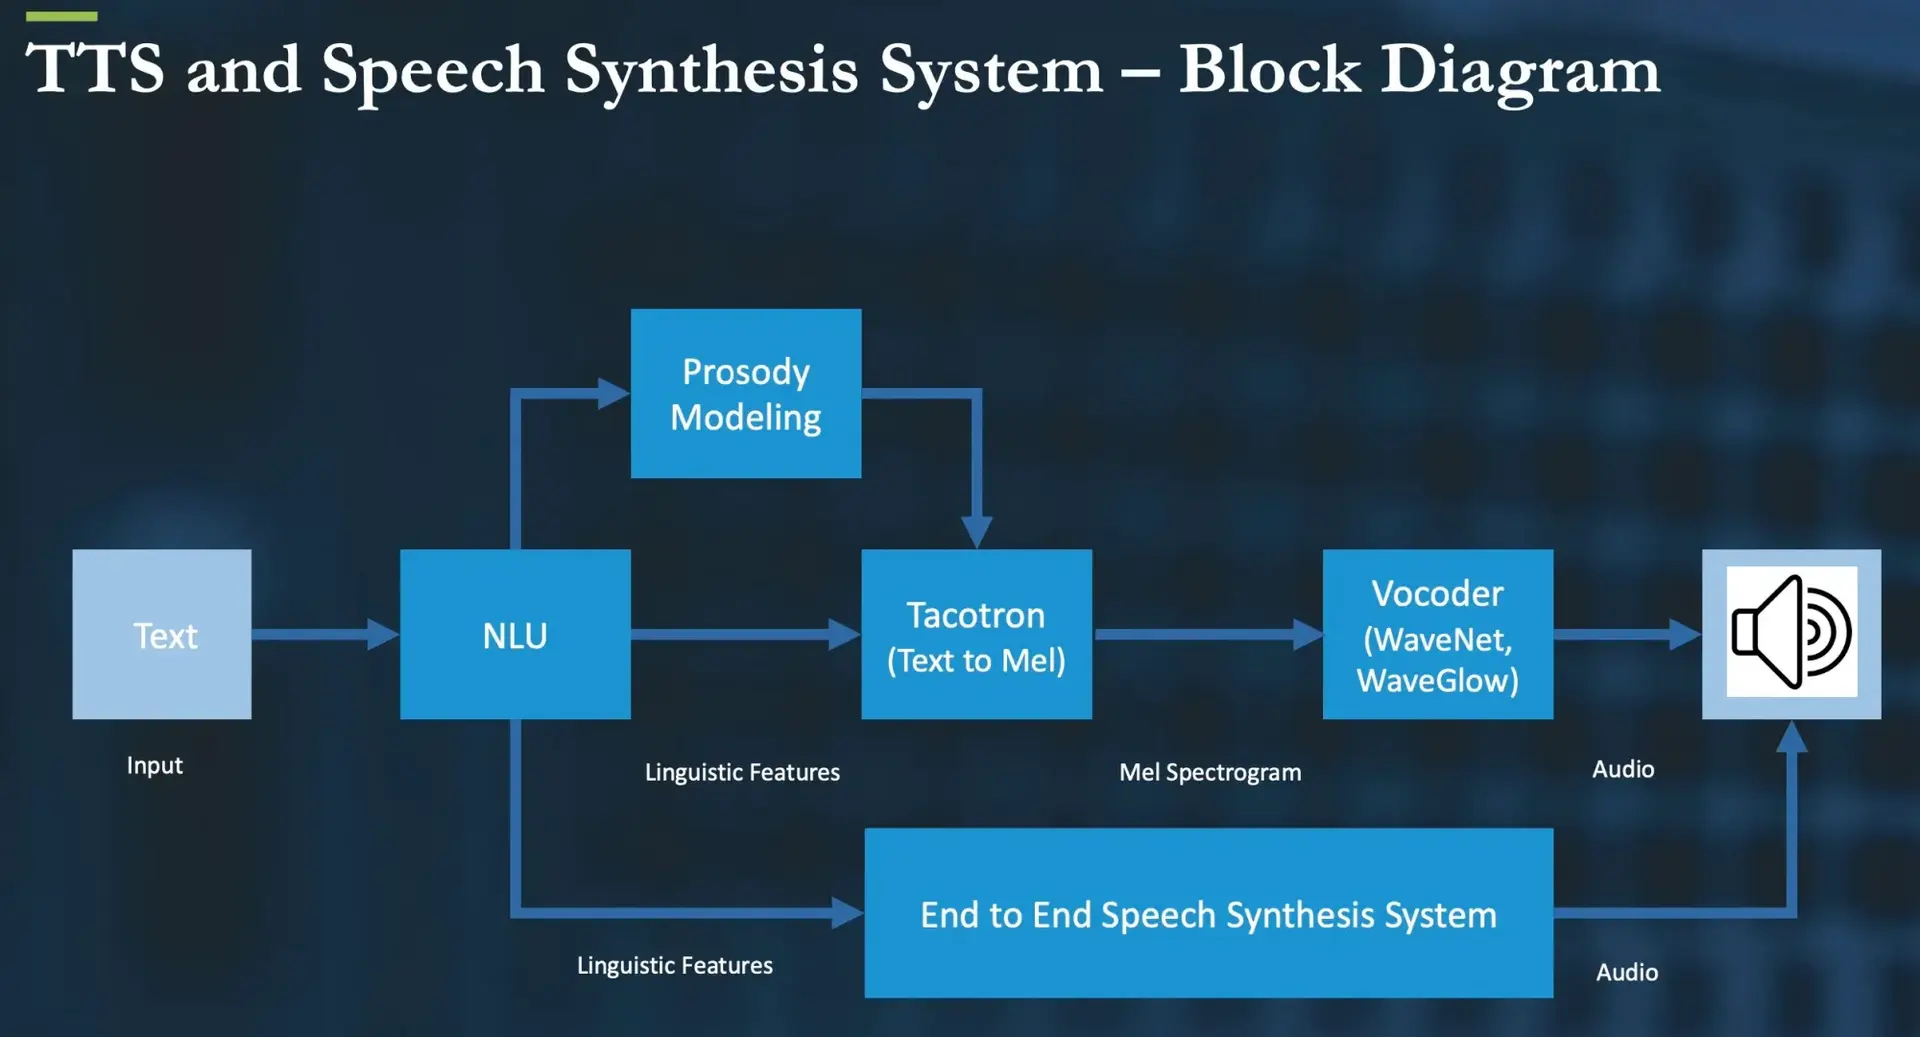
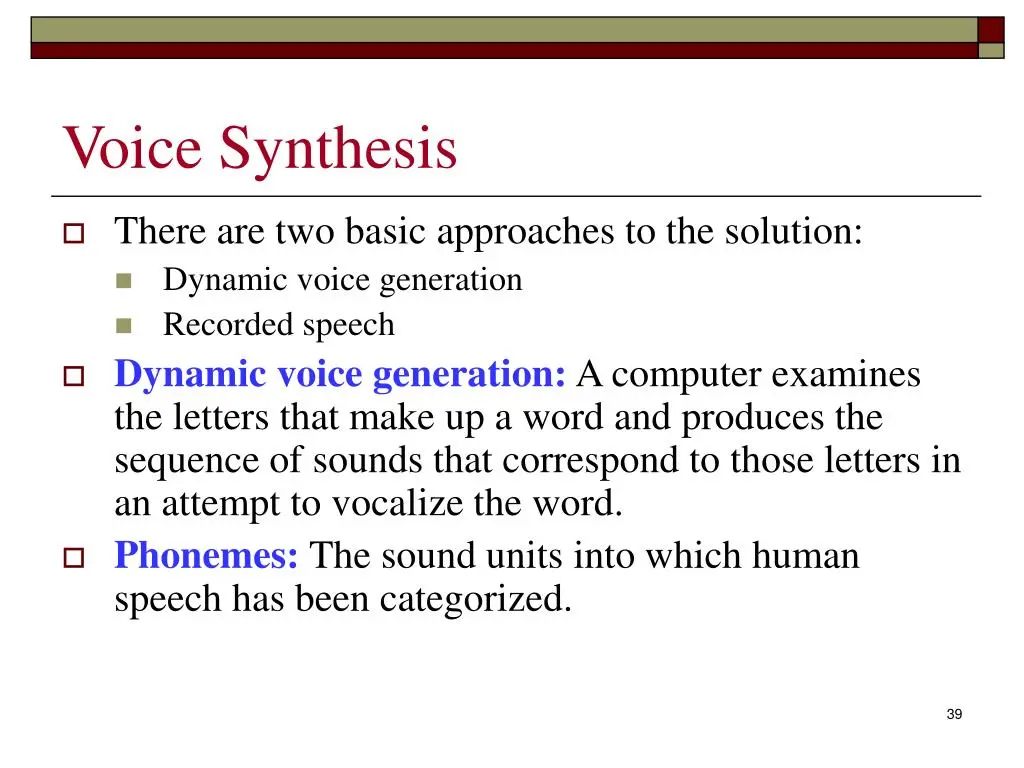
شبیهسازی صدای انسان با هوش مصنوعی بر اساس دو روش اصلی انجام میشود: روشهای مبتنی بر مدلهای آماری و روشهای مبتنی بر شبکههای عصبی عمیق. در روشهای آماری، الگوریتمها از دادههای صوتی موجود برای تولید صداهای جدید استفاده میکنند، در حالی که روشهای مبتنی بر شبکههای عصبی عمیق مانند مدلهای GAN (Generative Adversarial Networks) یا TTS (Text-to-Speech) بهطور دقیقتر و طبیعیتر صدا را تولید میکنند.
یکی از روشهای محبوب در این زمینه استفاده از مدلهای مبتنی بر شبکههای عصبی بازگشتی (RNN) یا ترانسفورمر است. این مدلها قادرند با تحلیل دادههای صوتی و متنی، صداهای طبیعیتری تولید کنند. برای مثال، مدلهای مانند Tacotron یا WaveNet از این نوع شبکهها استفاده میکنند تا صداهای انسانی را با کیفیت بالا شبیهسازی کنند.
مراحل کلی تولید صدا با هوش مصنوعی
فرایند تولید صدا با هوش مصنوعی شامل چند مرحله اصلی است:
- دادهگیری: جمعآوری نمونههای صوتی با کیفیت بالا از افراد مختلف برای آموزش مدل. این نمونهها باید شامل صدای افراد با سن، جنسیت و لحن مختلف باشند.
- پیشپردازش: پردازش دادههای صوتی برای حذف نویز و تبدیل آنها به فرمت مناسب برای آموزش مدل.
- آموزش مدل: استفاده از الگوریتمهای یادگیری عمیق برای آموزش مدل بر اساس دادههای جمعآوری شده.
- تولید صدا: تبدیل متن به صدا با استفاده از مدل آموزش دیده.
- پستپردازش: بهبود کیفیت صدا با استفاده از فیلترهای صوتی و تکنیکهای پردازش سیگنال.
در این میان، انتخاب دادههای مناسب و آموزش مدل با دقت بالا از اهمیت ویژهای برخوردار است. اگر دادههای آموزش ناکافی یا نویزدار باشند، کیفیت صدا تولید شده نیز تحت تأثیر قرار خواهد گرفت.
نکات کاربردی برای تولید صدا با کیفیت بالا
برای تولید صداهای طبیعی و با کیفیت با استفاده از هوش مصنوعی، باید به چند نکته کاربردی توجه کرد:
- کیفیت داده: استفاده از دادههای صوتی با کیفیت بالا و بدون نویز ضروری است. دادههای نویزدار یا با کیفیت پایین میتوانند منجر به تولید صداهای غیرطبیعی شوند.
- تنوع داده: مدل باید با دادههای متنوع از نظر جنسیت، سن و لحن آموزش داده شود تا بتواند صداهای مختلف را تولید کند.
- پردازش پیشرفته: استفاده از تکنیکهای پیشپردازش مانند حذف نویز و نرمالسازی دادهها میتواند کیفیت صدا را بهبود بخشد.
- تuning مدل: تنظیم دقیق پارامترهای مدل برای دستیابی به بهترین نتیجه ضروری است. این کار ممکن است نیاز به آزمایش و خطا داشته باشد.
- پستپردازش: استفاده از فیلترهای صوتی برای بهبود صدا و حذف نویزهای باقیمانده پس از تولید.
همچنین، استفاده از ابزارهای مناسب برای تحلیل و بهبود صدا نیز میتواند کمک زیادی کند. برای مثال، نرمافزارهای مانند Audacity یا Adobe Audition میتوانند در پردازش صداهای تولید شده مفید باشند.
اشتباهات رایج و چگونگی جلوگیری از آنها
در استفاده از هوش مصنوعی برای شبیهسازی صدا، برخی اشتباهات رایج وجود دارد که میتواند کیفیت نهایی را تحت تأثیر قرار دهد:
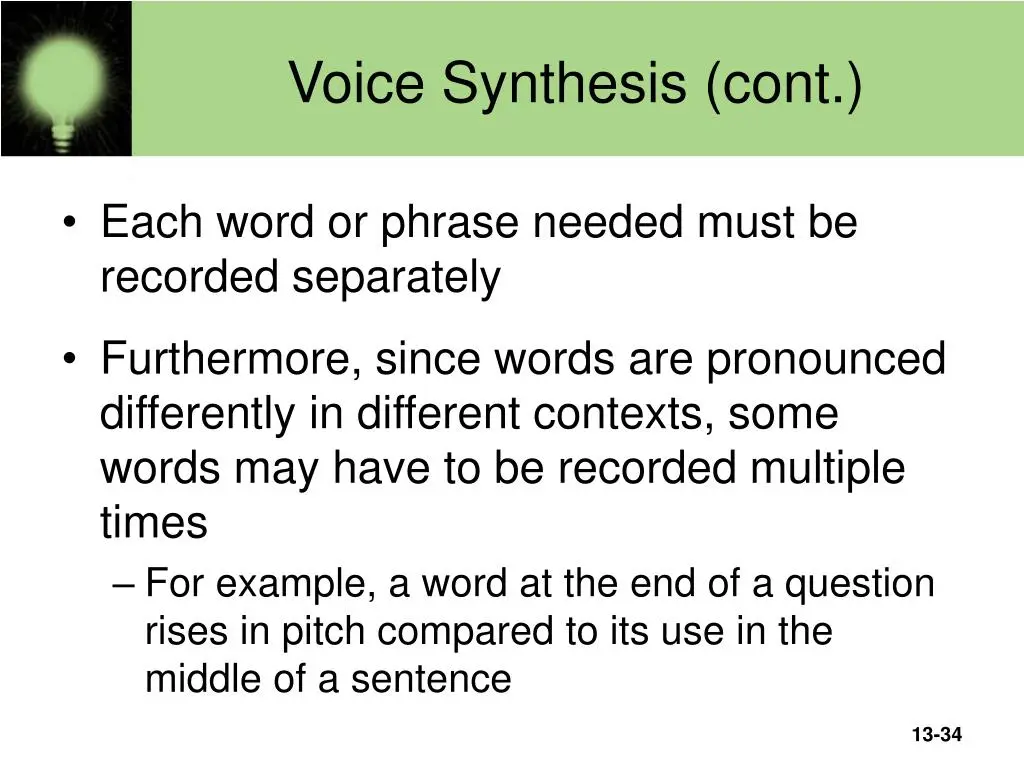
- استفاده از دادههای ناکافی: اگر مدل با دادههای کم آموزش داده شود، صداهای تولید شده ممکن است غیرطبیعی یا ناکارآمد باشند. برای جلوگیری از این مشکل، باید از دادههای متنوع و کافی استفاده کرد.
- نادیده گرفتن پیشپردازش: عدم پردازش دادههای صوتی قبل از آموزش مدل میتواند منجر به تولید صداهای نویزدار شود. استفاده از فیلترهای مناسب برای حذف نویز ضروری است.
- تنظیم نادرست پارامترهای مدل: تنظیم نادرست پارامترهای مدل میتواند کیفیت صدا را کاهش دهد. برای جلوگیری از این مشکل، باید پارامترهای مدل را با دقت تنظیم کرد.
- استفاده از مدلهای قدیمی: استفاده از مدلهای قدیمی یا غیرمعمول میتواند منجر به کیفیت پایینتر صدا شود. استفاده از مدلهای جدیدتر و پیشرفتهتر مانند ترانسفورمرها میتواند کیفیت را بهبود بخشد.
- نادیده گرفتن پستپردازش: عدم استفاده از تکنیکهای پستپردازش میتواند نویزهای باقیمانده را در صداهای تولید شده حفظ کند. استفاده از فیلترهای صوتی برای بهبود کیفیت ضروری است.
در نهایت، برای دستیابی به بهترین نتیجه، باید به روز بودن دانش در زمینه هوش مصنوعی و تکنیکهای پردازش صدا را حفظ کرد. این امر میتواند در بهبود کیفیت و کارایی سیستم کمک زیادی کند.
کاربردهای عملی شبیهسازی صدا با هوش مصنوعی
شبیهسازی صدا با هوش مصنوعی در حوزههای مختلفی کاربرد دارد. برخی از این کاربردها شامل:
- تولید محتوای صوتی برای بازیها و فیلمها، که در آن صداهای انسانی طبیعی مورد نیاز است.
- خدمات مشتری، که در آن استفاده از صداهای مصنوعی برای پاسخگویی به سوالات مشتریان میتواند هزینهها را کاهش دهد.
- خواندن کتاب صوتی، که در آن استفاده از صداهای مصنوعی میتواند کتابها را برای افراد نابینا یا کسانی که وقت خواندن ندارند، قابل دسترسی کند.
- کاربردهای پزشکی، مانند تولید صدا برای افراد مبتلا به اختلالات گفتاری.
- کاربردهای آموزشی، مانند تولید صدا برای آموزش زبان یا سایر موضوعات.
با پیشرفت فناوری، کاربردهای جدیدی نیز برای این تکنولوژی پیشبینی میشود. برای مثال، استفاده از صداهای مصنوعی در خودروهای خودران برای تعامل با سرنشینان یا استفاده از آن در رباتیک برای تولید صداهای طبیعیتر در رباتها.
در پایان، میتوان گفت که شبیهسازی صدا با هوش مصنوعی یک فناوری در حال رشد است که با پیشرفتهای روزافزون در زمینه یادگیری عمیق و پردازش سیگنال، کاربردهای جدیدی را به وجود خواهد آورد. برای استفاده مؤثر از این فناوری، باید به نکات کاربردی و جلوگیری از اشتباهات رایج توجه کرد. اگر به دنبال اطلاعات بیشتر در زمینه هوش مصنوعی و کاربردهای آن در صنایع مختلف هستید، میتوانید به مقالات مرتبط در ماشین مگ مراجعه کنید.