هوش مصنوعی و الگوریتمهای یادگیری ماشین امروزه در بسیاری از جنبههای زندگی ما حضور دارند؛ از پیشنهادات خرید در سایتهای اینترنتی گرفته تا تصمیمگیریهای پزشکی و حتی ارزیابیهای استخدامی. اما یکی از چالشهای اساسی که این فناوریها با آن روبرو هستند، سوگیری در هوش مصنوعی است. سوگیری در الگوریتمها به این معناست که سیستمها بهطور ناخواسته یا حتی عمدی، نتایج نابرابر یا نادرست تولید میکنند، و این موضوع میتواند تأثیرات جدی بر جامعه داشته باشد. در این مقاله، به بررسی مفهوم سوگیری در هوش مصنوعی، دلایل بروز آن، انواع مختلف آن و راهکارهایی برای کاهش این مشکل میپردازیم.
سوگیری در هوش مصنوعی چیست؟
سوگیری در هوش مصنوعی به معنای وجود خطا یا نابرابری در عملکرد الگوریتمها است که باعث میشود نتایج تولیدی آنها بهطور ناعادلانه یا نادرست عمل کنند. این سوگیریها میتوانند از دادههای ورودی، روشهای طراحی الگوریتم یا حتی اهداف برنامهنویسان ناشی شوند. برای مثال، اگر یک الگوریتم برای تشخیص چهره آموزش دیده باشد و دادههای آموزشی آن بیشتر شامل افراد با پوست روشن باشد، احتمالاً در تشخیص چهره افراد با پوست تیره دقت کمتری خواهد داشت.
سوگیری در هوش مصنوعی میتواند در انواع مختلفی بروز کند، از جمله:
- سوگیری دادهای: زمانی که دادههای آموزشی الگوریتم ناکافی، نابرابر یا دارای خطا هستند.
- سوگیری الگوریتمی: زمانی که طراحی خود الگوریتم باعث ایجاد نابرابری میشود.
- سوگیری برنامهنویس: زمانی که اهداف یا فرضیات برنامهنویسان در طراحی الگوریتم منعکس میشود.
این سوگیریها میتوانند منجر به تصمیمگیریهای نادرست در زمینههای مختلف شوند، مانند:
- ارزیابیهای استخدامی ناعادلانه
- توزیع نادرست خدمات بانکی یا بیمهای
- تشخیص نادرست در سیستمهای پزشکی
- پیشنهادات نابرابر در خدمات آنلاین
چرا الگوریتمها بیطرف نیستند؟
الگوریتمها بهطور ذاتی بیطرف نیستند، زیرا بر اساس دادهها و اهداف تعریفشده توسط انسانها طراحی میشوند. اگر دادههای آموزشی نابرابر یا دارای سوگیری باشند، الگوریتم نیز همان سوگیری را تقلید خواهد کرد. علاوه بر این، اهداف و فرضیات برنامهنویسان میتواند در طراحی الگوریتم منعکس شود. برای مثال، اگر یک الگوریتم برای ارزیابی رزومههای استخدامی طراحی شود و دادههای آموزشی آن بیشتر شامل افراد با تحصیلات دانشگاهی باشد، ممکن است افراد با تحصیلات غیر دانشگاهی بهطور ناعادلانه ارزیابی شوند.
یکی از دلایل اصلی بیطرفی نبودن الگوریتمها، عدم آگاهی برنامهنویسان از وجود سوگیری در دادهها یا الگوریتم است. همچنین، برخی از سوگیریها ممکن است عمدی باشند، مانند زمانی که یک شرکت میخواهد محصولات خود را به گروه خاصی از مشتریان پیشنهاد دهد.
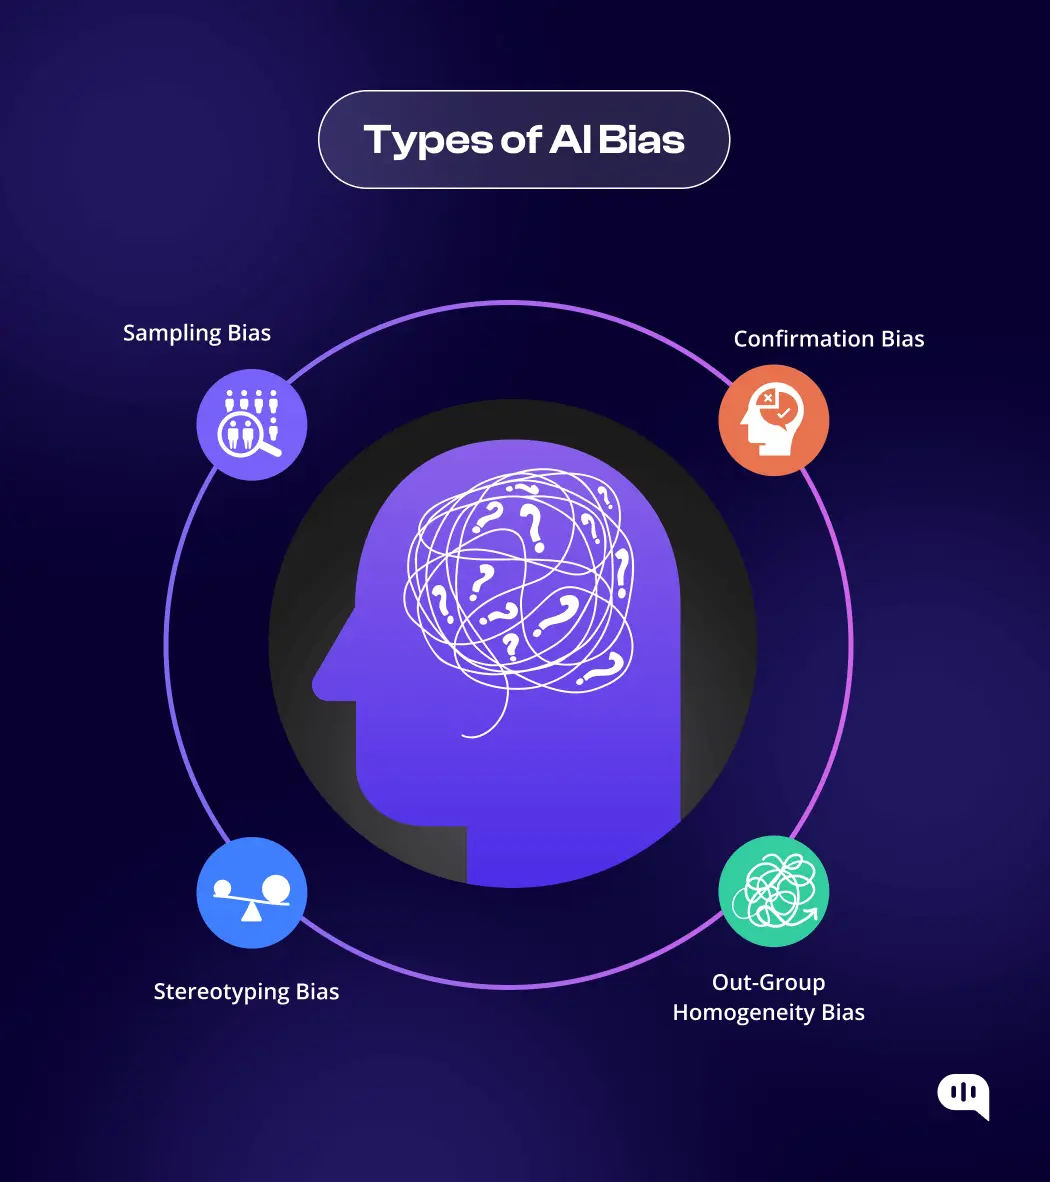
انواع سوگیری در هوش مصنوعی
سوگیری در هوش مصنوعی میتواند در انواع مختلفی بروز کند. در ادامه، به بررسی برخی از انواع رایج آن میپردازیم:
۱. سوگیری دادهای
سوگیری دادهای زمانی رخ میدهد که دادههای آموزشی الگوریتم ناکافی، نابرابر یا دارای خطا باشند. برای مثال، اگر یک الگوریتم برای تشخیص بیماریهای قلبی آموزش ببیند و دادههای آموزشی آن بیشتر شامل مردان باشد، ممکن است در تشخیص بیماری در زنان دقت کمتری داشته باشد.
این نوع سوگیری میتواند به دلیل عدم تنوع در دادهها، خطاهای ثبت داده یا حتی عدم وجود دادههای کافی برای گروههای خاصی از جمعیت بروز کند.
۲. سوگیری الگوریتمی
سوگیری الگوریتمی زمانی رخ میدهد که طراحی خود الگوریتم باعث ایجاد نابرابری میشود. برای مثال، اگر یک الگوریتم برای رتبهبندی مقالات علمی طراحی شود و وزن بیشتری به مقالات منتشر شده در مجلات معتبر بگذارد، ممکن است مقالات جدیدتر یا منتشر شده در مجلات کمتر شناختهشده بهطور ناعادلانه رتبهبندی شوند.
این نوع سوگیری میتواند به دلیل انتخاب نادرست ویژگیها، استفاده از روشهای نابرابر در آموزش الگوریتم یا حتی طراحی نادرست مدل بروز کند.
۳. سوگیری برنامهنویس
سوگیری برنامهنویس زمانی رخ میدهد که اهداف یا فرضیات برنامهنویسان در طراحی الگوریتم منعکس شود. برای مثال، اگر یک الگوریتم برای ارزیابی رزومههای استخدامی طراحی شود و برنامهنویس فرض کند که افراد با تحصیلات دانشگاهی بهتر هستند، این فرض ممکن است در الگوریتم منعکس شود و افراد با تحصیلات غیر دانشگاهی بهطور ناعادلانه ارزیابی شوند.
این نوع سوگیری میتواند به دلیل عدم آگاهی برنامهنویسان از وجود سوگیری یا حتی عمدی بودن برخی از اهداف بروز کند.
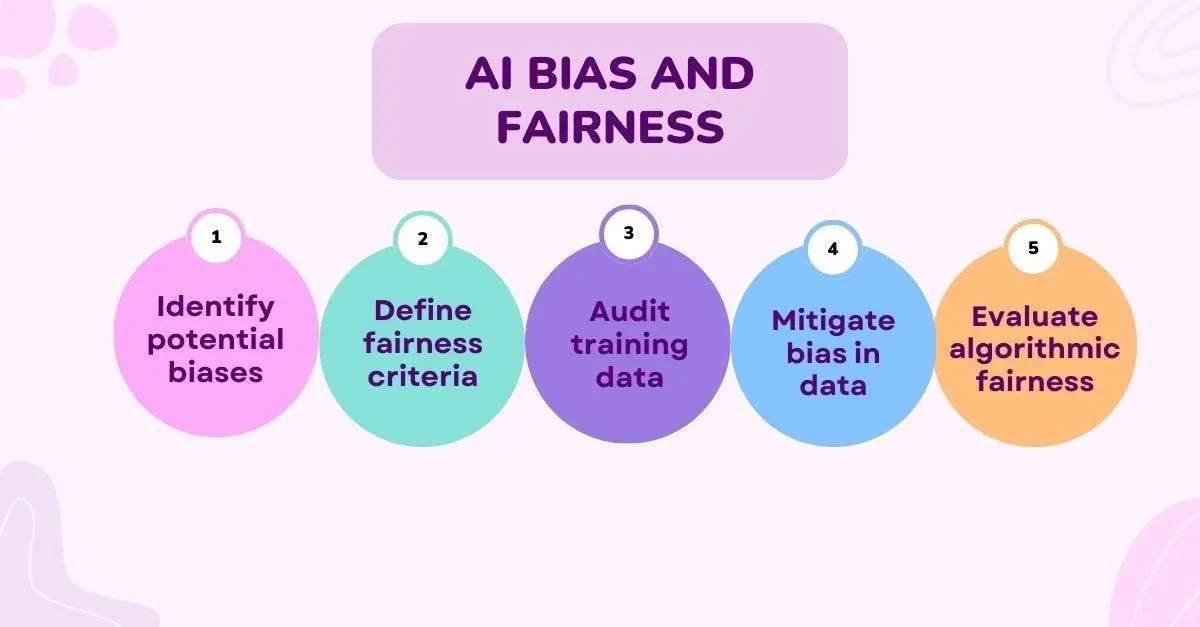
چگونه میتوان سوگیری در الگوریتمها را کاهش داد؟
کاهش سوگیری در الگوریتمها نیازمند توجه به چندین عامل است. در ادامه، به برخی از راهکارهای مؤثر برای کاهش سوگیری در هوش مصنوعی میپردازیم:
۱. استفاده از دادههای متنوع و با کیفیت
یکی از مهمترین راهکارها برای کاهش سوگیری، استفاده از دادههای متنوع و با کیفیت است. دادههای آموزشی باید شامل گروههای مختلفی از جمعیت باشد تا الگوریتم بتواند بهطور عادلانه عمل کند. همچنین، باید از دادههای با کیفیت بالا استفاده کرد تا خطاهای ثبت داده کاهش یابد.
۲. بررسی و ارزیابی مداوم الگوریتمها
بررسی مداوم عملکرد الگوریتمها و ارزیابی سوگیریهای احتمالی در آنها میتواند کمک زیادی کند. این بررسیها میتواند شامل تحلیل دادههای ورودی و خروجی الگوریتم، ارزیابی دقت الگوریتم در گروههای مختلف و استفاده از ابزارهای تشخیص سوگیری باشد.
۳. طراحی الگوریتمهای عادلانه
در طراحی الگوریتمها، باید به این نکته توجه کرد که اهداف و فرضیات برنامهنویسان بهطور عادلانه در الگوریتم منعکس شود. استفاده از روشهای عادلانه در انتخاب ویژگیها، آموزش الگوریتم و ارزیابی نتایج میتواند کمک زیادی به کاهش سوگیری کند.
۴. آموزش و آگاهی برنامهنویسان
آگاهی برنامهنویسان از وجود سوگیری در دادهها و الگوریتمها و آموزش آنها در زمینه تشخیص و کاهش سوگیری میتواند تأثیر زیادی داشته باشد. شرکتها میتوانند با ارائه دورههای آموزشی و کارگاههای تخصصی، برنامهنویسان خود را در این زمینه آموزش دهند.
۵. استفاده از ابزارهای تشخیص سوگیری
ابزارهای مختلفی برای تشخیص سوگیری در الگوریتمها وجود دارد که میتوان از آنها برای شناسایی و کاهش سوگیری استفاده کرد. این ابزارها میتوانند شامل تحلیل دادهها، ارزیابی دقت الگوریتم در گروههای مختلف و استفاده از روشهای آماری برای تشخیص سوگیری باشند.
نتیجهگیری
سوگیری در هوش مصنوعی یکی از چالشهای اساسی این فناوری است که میتواند تأثیرات جدی بر جامعه داشته باشد. درک مفهوم سوگیری، شناسایی انواع مختلف آن و استفاده از راهکارهای مؤثر برای کاهش سوگیری میتواند کمک زیادی به طراحی الگوریتمهای عادلانهتر کند. با توجه به اهمیت این موضوع، شرکتها و برنامهنویسان باید بهطور مداوم در تلاش باشند تا سوگیری در الگوریتمها را کاهش دهند و از عدالت در تصمیمگیریهای خودکار اطمینان حاصل کنند.
برای اطلاعات بیشتر در زمینه هوش مصنوعی و چالشهای آن، میتوانید به مقالات مرتبط در ماشین مگ مراجعه کنید.