در چند سال گذشته، پیشرفتهای چشمگیر در زمینه هوش مصنوعی باعث شده است که فناوریهای جدیدی به زندگی روزمره ما وارد شوند. یکی از این فناوریها که توجه بسیاری را به خود جلب کرده، صدای مصنوعی و توانایی سیستمهای هوشمند در تولید گفتار طبیعی است. اما چگونه این فناوری کار میکند؟ چه تفاوتی بین صدای مصنوعی و صدای انسانی وجود دارد؟ و چقدر این صداها به انسان نزدیک شدهاند؟ در این راهنمای کامل، به بررسی مفاهیم اساسی، چگونگی عملکرد و همچنین محدودیتهای این فناوری میپردازیم.
راوی هوش مصنوعی چیست؟
راوی هوش مصنوعی یا Text-to-Speech (TTS) یک فناوری است که متن را به گفتار تبدیل میکند. این سیستمها با استفاده از الگوریتمهای پیچیده و مدلهای یادگیری عمیق، قادر به تولید صدایی هستند که به حد امکان شبیه به صدای انسانی باشد. در گذشته، صدای تولیدشده توسط این سیستمها بسیار رباتیک و غیرطبیعی به نظر میرسید، اما امروزه با پیشرفتهای جدید، کیفیت صدای مصنوعی بهطور قابل توجهی بهبود یافته است.
این فناوری در کاربردهای مختلفی مانند خواندن کتاب برای افراد نابینا، تولید صدای برای سیستمهای صوتی خودرو، کمک به افراد با ناتوانیهای گفتاری و حتی در تولید محتواهای صوتی استفاده میشود. یکی از مهمترین مزایای این فناوری، توانایی تولید صدای طبیعی در زبانهای مختلف و با لحنهای گوناگون است.
چگونه صدای مصنوعی تولید میشود؟
پردازش صدای مصنوعی شامل چند مرحله اصلی است:
- تحلیل صدای انسانی: در این مرحله، صدای انسانها ضبط و تحلیل میشود تا الگوی تولید صدا در گلو، زبان و لبها مشخص شود.
- مدلسازی: با استفاده از دادههای جمعآوریشده، مدلهای یادگیری ماشین آموزش میبینند تا بتوانند صدای طبیعی تولید کنند.
- سنتز صدا: در این مرحله، متن وارد سیستم میشود و با استفاده از مدلهای یادگیری عمیق، به صدا تبدیل میشود.
- پیشپردازش و بهبود: برای افزایش کیفیت صدا، فیلترهای مختلفی اعمال میشود تا صدای نهایی طبیعیتر به نظر برسد.
یکی از روشهای پیشرفته در این زمینه استفاده از شبکههای عصبی عمیق است که میتواند صدای بسیار طبیعی تولید کند. این شبکهها با آموزش بر روی هزاران ساعت صدای انسانی، قادر به تولید صدایی هستند که حتی برای شنوندگان غیرمتخصص تشخیص آن از صدای واقعی دشوار است.
چقدر صدای مصنوعی به انسان نزدیک شده است؟
در سالهای گذشته، صدای مصنوعی بهطور قابل توجهی پیشرفت کرده است. امروزه بسیاری از سیستمها قادر به تولید صدایی هستند که در بسیاری از موارد غیرقابل تشخیص از صدای انسانی است. اما هنوز تفاوتهایی بین صدای مصنوعی و طبیعی وجود دارد:
- طبیعت و لحن: صدای مصنوعی هنوز در برخی موارد مانند تغییر لحن در لحظه یا تولید صدای عاطفی مانند غم یا شادی با دقت کامل کار نمیکند.
- دقت تلفظ: در برخی زبانها یا کلمات پیچیده، صدای مصنوعی ممکن است دقت لازم را نداشته باشد.
- پویایی: صدای انسانی دارای تغییرات ریز در لحن و ریتم است که صدای مصنوعی هنوز بهطور کامل آن را تقلید نمیکند.
با این حال، پیشرفتهای اخیر در زمینه هوش مصنوعی و یادگیری عمیق نشان میدهد که این تفاوتها در آینده نزدیک کاهش خواهد یافت. امروزه بسیاری از سیستمها مانند Google WaveNet یا Amazon Polly قادر به تولید صدایی بسیار طبیعی هستند که در بسیاری از کاربردها قابل استفاده است.
کاربردهای عملی صدای مصنوعی
صدای مصنوعی در زمینههای مختلفی کاربرد دارد. برخی از مهمترین کاربردها عبارتند از:
- کتابخوانی برای افراد نابینا: سیستمهای TTS به افراد نابینا امکان میدهند تا کتابها و مقالات را با صدای طبیعی بشنوند.
- سیستمهای صوتی خودرو: بسیاری از خودروهای امروزی از صدای مصنوعی برای اطلاعرسانی به سرنشینان استفاده میکنند.
- پشتیبانی مشتری: بسیاری از شرکتها از رباتهای صوتی برای پاسخگویی به سوالات مشتریان استفاده میکنند.
- تولید محتوا: در تولید پادکستها، برنامههای رادیویی و حتی فیلمها، صدای مصنوعی به عنوان یک ابزار مهم استفاده میشود.
- کمک به افراد با ناتوانیهای گفتاری: این فناوری به افراد مبتلا به ناتوانیهای گفتاری امکان میدهد تا با استفاده از دستگاههای خاص، با دیگران ارتباط برقرار کنند.
با پیشرفت فناوری، کاربردهای جدیدی نیز برای صدای مصنوعی پیشبینی میشود. برای مثال، در آینده نزدیک ممکن است سیستمهای هوشمند بتوانند با لحن و صدای کاملا طبیعی با انسانها گفتگو کنند و حتی احساسات را منتقل کنند.
چالشهای پیش روی صدای مصنوعی
با وجود پیشرفتهای چشمگیر، هنوز چالشهایی در راه تولید صدای کاملا طبیعی وجود دارد:
- دقت در تلفظ: برخی از زبانها یا لهجهها هنوز بهطور کامل توسط سیستمها پشتیبانی نمیشوند.
- پویایی و لحن: تولید صدای کاملا طبیعی با تغییرات لحن و احساسات هنوز یک چالش بزرگ است.
- سرعت پردازش: تولید صدای بسیار سریع و طبیعی بدون افت کیفیت هنوز یک مشکل است.
- خصوصیت شخصی: تولید صدای کاملا مشابه صدای یک فرد خاص هنوز یک چالش فنی است.
با این حال، با پیشرفتهای روزافزون در زمینه هوش مصنوعی و یادگیری عمیق، بسیاری از این چالشها در آینده نزدیک حل خواهند شد. تحقیقات جاری نشان میدهد که سیستمهای جدید قادر به تولید صدایی هستند که حتی برای شنوندگان متخصص نیز تشخیص آن از صدای واقعی دشوار است.
آینده صدای مصنوعی
با توجه به پیشرفتهای اخیر، آینده صدای مصنوعی بسیار روشن به نظر میرسد. در آینده نزدیک، میتوانیم شاهد تولید صدایی باشیم که کاملا شبیه به صدای انسانی است و حتی قادر به انتقال احساسات و لحنهای مختلف خواهد بود. این فناوری میتواند در زمینههای مختلفی مانند آموزش، سرگرمی، ارتباطات و حتی درمانی کاربرد داشته باشد.
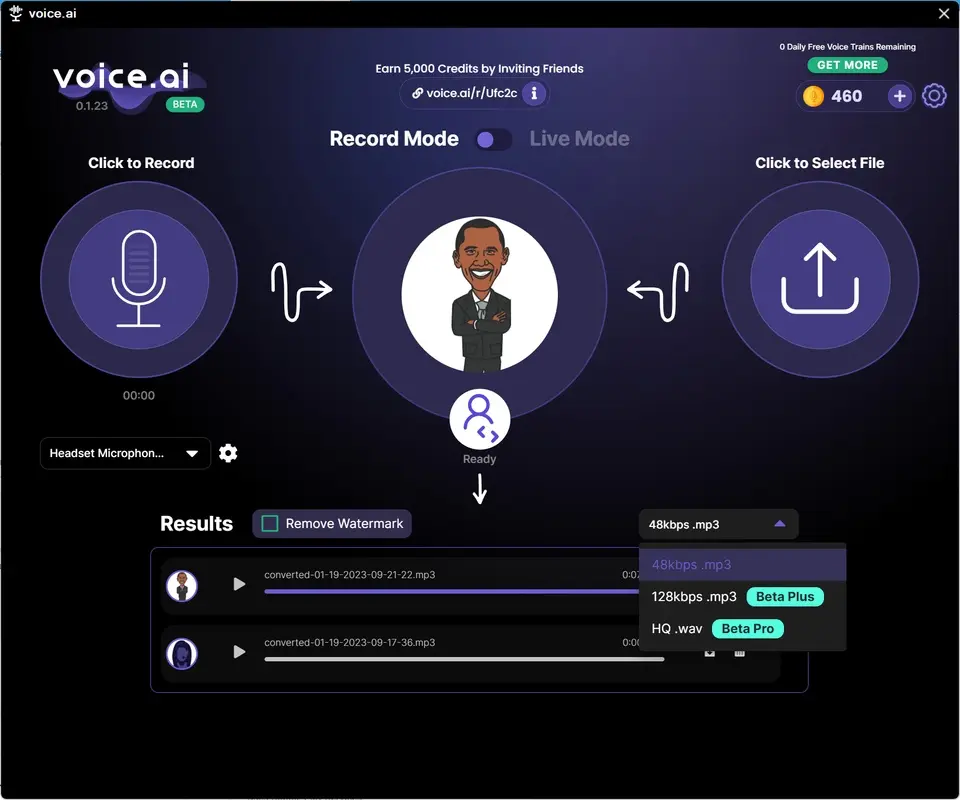
یکی از کاربردهای جالب آینده این فناوری، تولید صدای شخصی برای افراد است. برای مثال، افراد میتوانند با ضبط صدای خود، یک نسخه مصنوعی از آن تولید کنند که در صورت نیاز بتوانند از آن استفاده کنند. این کاربرد میتواند برای افراد مبتلا به بیماریهای عصبی یا افراد مسن که دچار تغییر در صدای خود شدهاند، بسیار مفید باشد.
همچنین، با پیشرفت فناوری، میتوانیم شاهد ادغام صدای مصنوعی با سایر فناوریهای هوشمند مانند واقعیت مجازی و واقعیت افزوده باشیم. این ادغام میتواند تجربههای جدیدی را در زمینه سرگرمی و آموزش ایجاد کند.
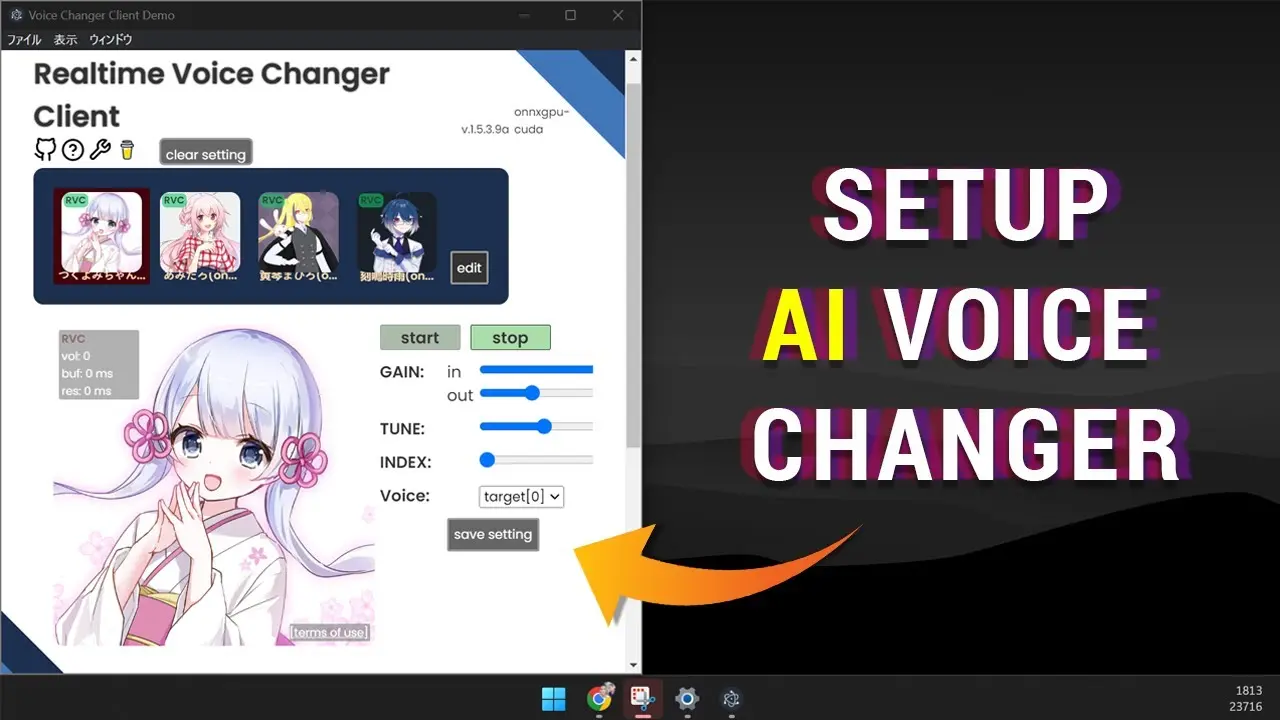
در نهایت، صدای مصنوعی یک فناوری در حال رشد است که میتواند بسیاری از جنبههای زندگی ما را تغییر دهد. با پیشرفتهای روزافزون، این فناوری بهطور فزایندهای به صدای انسانی نزدیکتر میشود و کاربردهای جدیدی را به وجود میآورد. برای اطلاعات بیشتر در مورد آخرین پیشرفتها در زمینه هوش مصنوعی و فناوریهای مرتبط، میتوانید به ماشین مگ مراجعه کنید.