هوش مصنوعی در سالهای اخیر با سرعت زیادی در پیشرفت است و یکی از روشهای مهم یادگیری ماشین، یادگیری تقویتی (Reinforcement Learning) است. این روش بر اساس تعامل بین یک عامل (agent) و محیط (environment) بنا شده و هدف آن یادگیری سیاستهای بهینه برای کسب پاداش بیشینه است. اما چگونه این فرایند کار میکند؟ چه تفاوتهایی با روشهای دیگر یادگیری ماشین دارد؟ و در چه زمینههایی کاربرد دارد؟ در این مقاله به بررسی مفاهیم اساسی، مکانیزمهای یادگیری، کاربردهای عملی و نکات مهم یادگیری تقویتی میپردازیم.
مفهوم پایهای یادگیری تقویتی
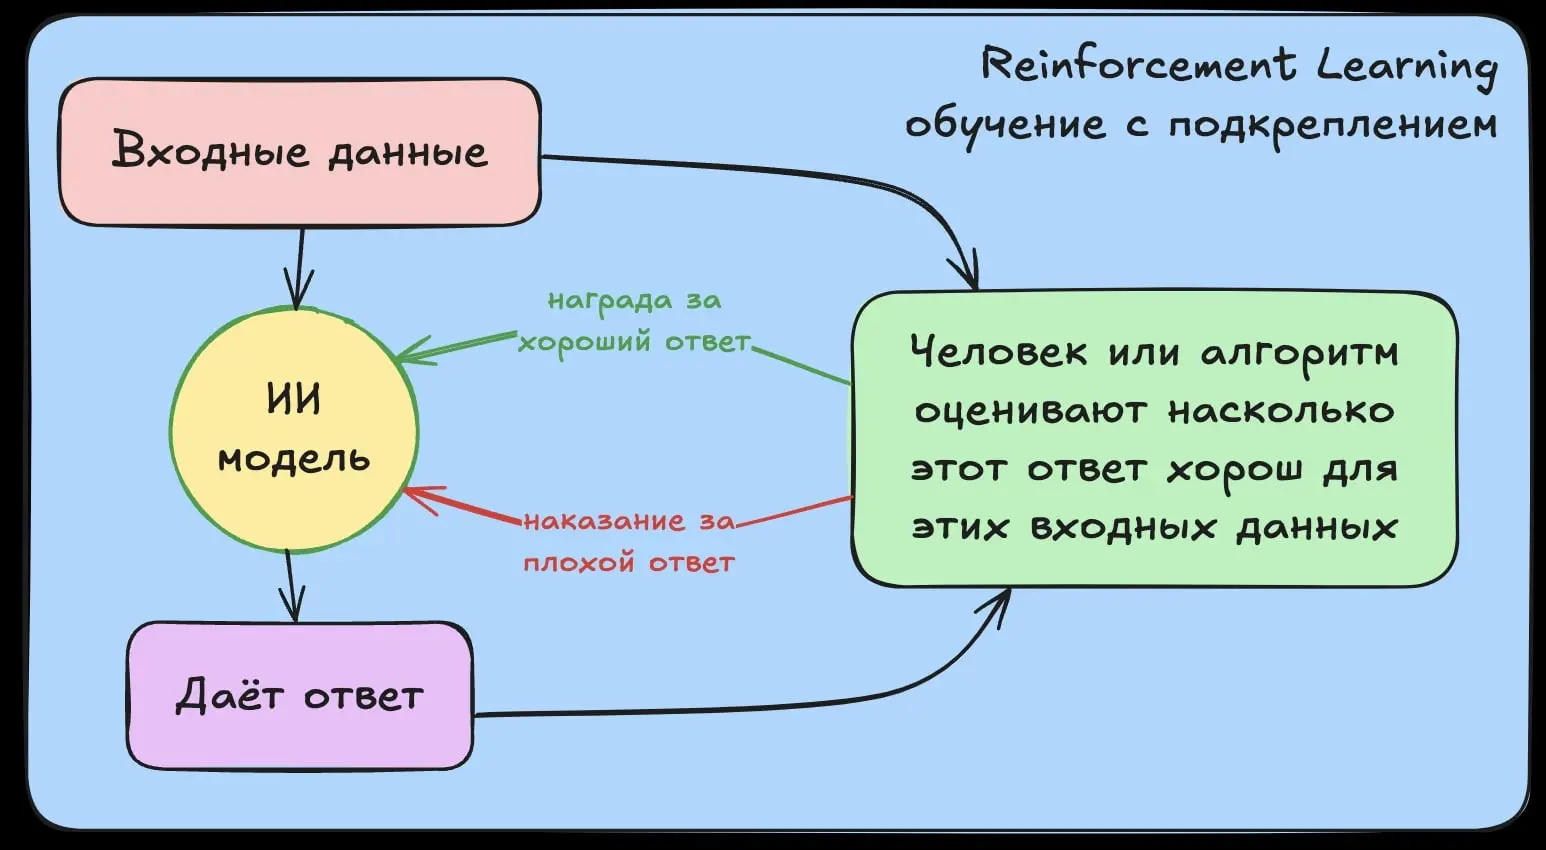
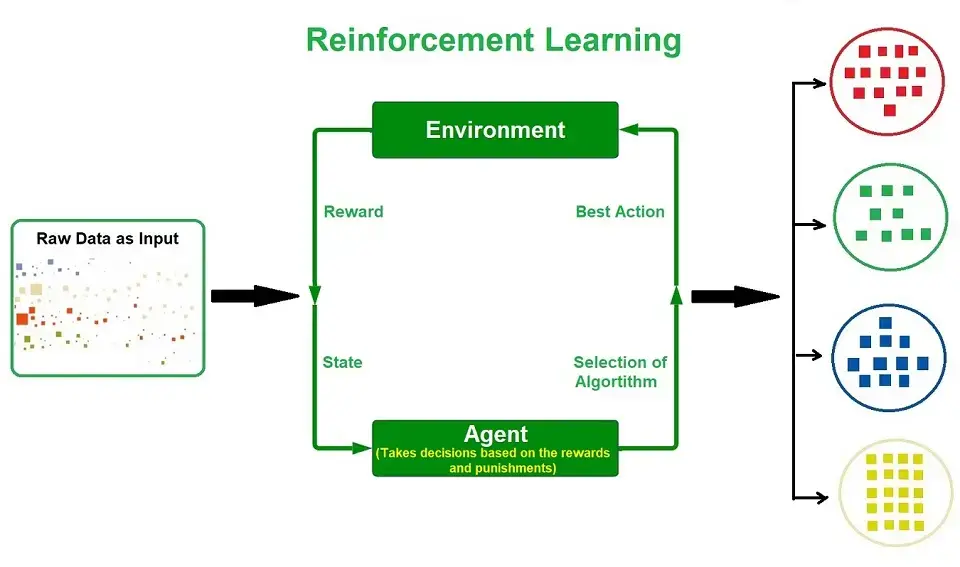
یادگیری تقویتی یک پارادایم یادگیری ماشین است که در آن یک عامل با محیط تعامل میکند و از طریق تجربه و دریافت پاداش یا جریمه، سیاستهای خود را بهینه میکند. در این روش، عامل هیچ دادهای از قبل ندارد و باید از طریق آزمایش و خطا، بهترین راهکار را بیابد. این روش به ویژه در شرایطی که دادههای برچسبدار (labeled data) در دسترس نیست، بسیار مؤثر عمل میکند.
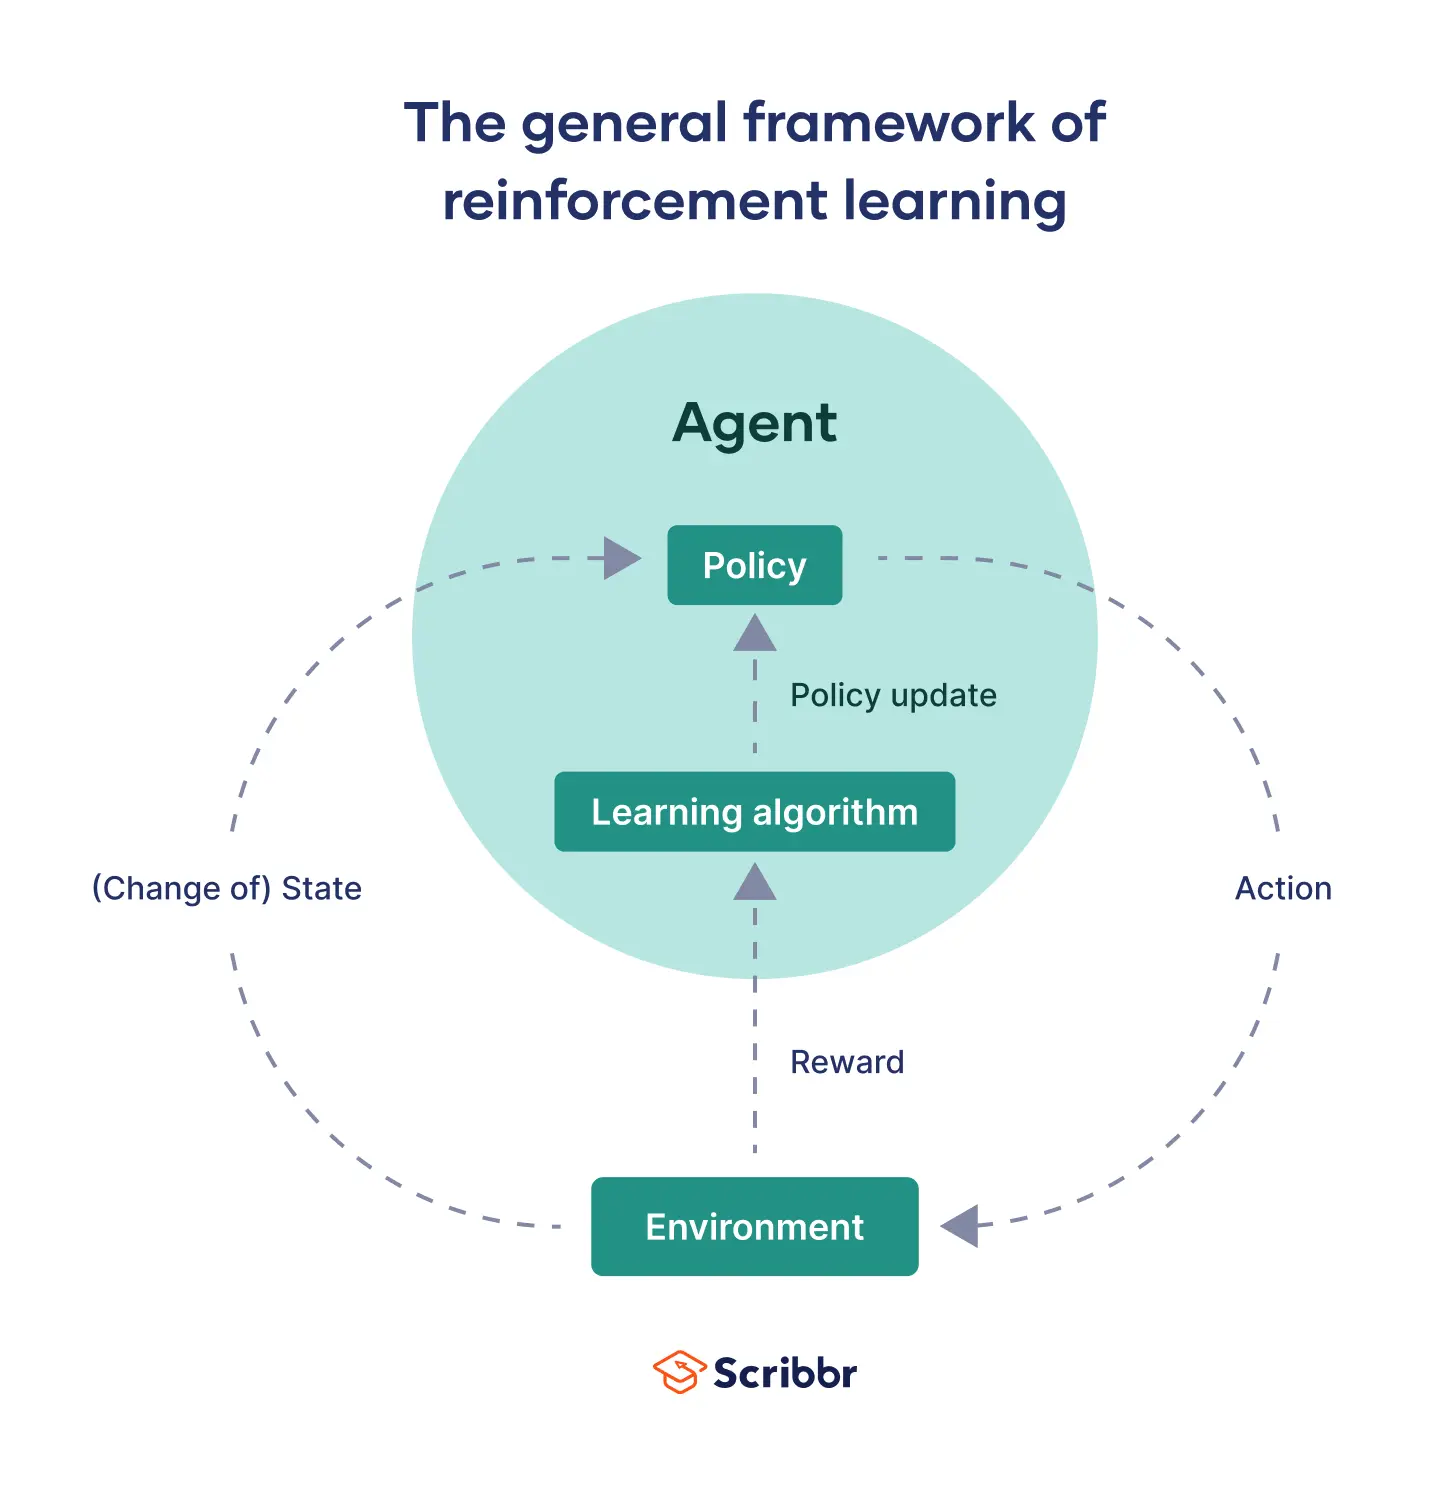
در یادگیری تقویتی، سه عنصر اصلی وجود دارد:
- عامل (Agent): این بخش تصمیمگیری میکند و اقدامات را در محیط انجام میدهد.
- محیط (Environment): محیطی که عامل در آن عمل میکند و به عامل پاسخ میدهد.
- پاداش (Reward): سیگنالی که نشاندهنده موفقیت یا شکست اقدامات عامل است و هدف عامل کسب پاداش بیشینه است.
این روش در واقع یک بازی دو نفره بین عامل و محیط است، جایی که عامل سعی دارد پاداش را بیشینه کند و محیط سعی دارد این کار را دشوارتر کند. این تعامل مداوم باعث میشود عامل سیاستهای بهتری برای تصمیمگیری یاد بگیرد.
چگونه هوش مصنوعی از پاداش و خطا یاد میگیرد؟
یادگیری در یادگیری تقویتی بر اساس تجربه و بازخورد است. عامل با انجام اقدامات مختلف، پاداش یا جریمه دریافت میکند و این اطلاعات برای بهبود سیاستهای آینده استفاده میشود. این فرایند به دو روش اصلی انجام میشود:
۱. یادگیری با سیاست ثابت (Policy-Based Learning)
در این روش، عامل یک سیاست (policy) دارد که تعیین میکند در هر حالت چه اقدامی انجام دهد. سیاست میتواند ثابت باشد یا به صورت دینامیک تغییر کند. هدف این است که سیاستی پیدا شود که انتظار پاداش در طول زمان را بیشینه کند. برای مثال، در بازیهای ویدئویی، سیاست میتواند تعیین کند که در هر مرحله چه کلیدی را فشار دهیم.
۲. یادگیری با ارزش (Value-Based Learning)
در این روش، عامل ارزش هر حالت یا اقدام را یادمیگیرد. ارزش نشاندهنده احتمال دریافت پاداش در آینده است. روشهای معروفی مانند Q-Learning از این دسته هستند. در Q-Learning، عامل یک جدول Q دارد که ارزش هر اقدام در هر حالت را ذخیره میکند و با بهروزرسانی این جدول، سیاست بهینه پیدا میشود.
یکی از چالشهای اصلی یادگیری تقویتی، تعادل بین اکتشاف (exploration) و استثمار (exploitation) است. عامل باید به اندازه کافی اکتشاف کند تا سیاستهای جدیدی بیاموزد، اما همزمان باید از سیاستهای موفق قبلی استفاده کند تا پاداش را بیشینه کند. روشهای مختلفی مانند epsilon-greedy یا Upper Confidence Bound (UCB) برای حل این چالش استفاده میشوند.
کاربردهای عملی یادگیری تقویتی
یادگیری تقویتی در بسیاری از زمینهها کاربرد دارد و به ویژه در مواردی که نیاز به تصمیمگیری در زمان واقعی و با تعامل مداوم با محیط وجود دارد، مؤثر است. برخی از کاربردهای مهم آن عبارتند از:
- رباتیک: رباتها میتوانند از یادگیری تقویتی برای یادگیری حرکات پیچیده و تعامل با محیط استفاده کنند. برای مثال، یک ربات میتواند با آزمایش و خطا یاد بگیرد چگونه یک شیء را با دقت بردارد یا در محیطی نامنظم حرکت کند.
- بازیهای ویدئویی: الگوریتمهای یادگیری تقویتی مانند Deep Q-Network (DQN) و AlphaGo توانستهاند در بازیهای پیچیده مانند شطرنج، گو و بازیهای ویدئویی مانند اتاری و StarCraft II به نتایج قابل توجهی برسند.
- سیستمهای خودران: خودروهای خودران از یادگیری تقویتی برای یادگیری تصمیمگیری در ترافیک، تشخیص مانع و انتخاب مسیر استفاده میکنند.
- پیشبینی مالی: در بازارهای مالی، الگوریتمهای یادگیری تقویتی میتوانند برای تصمیمگیری در خرید و فروش سهام و مدیریت پرتفوی استفاده شوند.
- بهینهسازی انرژی: در سیستمهای هوشمند انرژی، این روش میتواند برای بهینهسازی مصرف انرژی و مدیریت منابع استفاده شود.
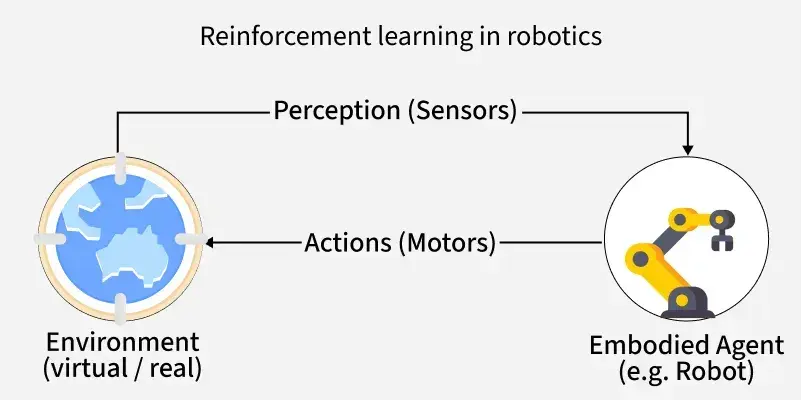
نکات مهم و چالشهای یادگیری تقویتی
در حالی که یادگیری تقویتی تواناییهای زیادی دارد، اما چالشهایی نیز در راه دارد. برخی از این چالشها عبارتند از:
- پایداری: الگوریتمها باید در برابر تغییرات محیط پایدار باشند. برای مثال، یک ربات باید بتواند در شرایط مختلف محیطی عملکرد خوبی داشته باشد.
- مقیاسپذیری: بسیاری از الگوریتمهای یادگیری تقویتی در محیطهای بزرگ و پیچیده مانند بازیهای ویدئویی یا سیستمهای خودران، با مشکل مقیاسپذیری مواجه هستند.
- تعیین پاداش: طراحی یک سیستم پاداش مناسب یکی از چالشهای اصلی است. پاداش باید به درستی تعریف شود تا عامل بتواند سیاستهای بهینه را یاد بگیرد.
- اکتشاف و استثمار: تعادل بین اکتشاف و استثمار باید به درستی مدیریت شود تا عامل همواره در حال یادگیری باشد و از سیاستهای موفق استفاده کند.
برای حل این چالشها، پژوهشگران از روشهای مختلفی مانند یادگیری عمیق تقویتی (Deep Reinforcement Learning)، یادگیری تقویتی با سیاستهای چندگانه (Multi-Agent Reinforcement Learning) و استفاده از دادههای پیشفرض استفاده میکنند. این روشها توانستهاند در بسیاری از کاربردها نتایج قابل توجهی به همراه داشته باشند.
یادگیری تقویتی در دنیای واقعی
یکی از نمونههای موفق کاربرد یادگیری تقویتی در دنیای واقعی، استفاده از آن در سیستمهای خودران است. برای مثال، شرکتهای خودروسازی مانند تسلا و وایمو از الگوریتمهای یادگیری تقویتی برای بهبود عملکرد خودروهای خود در شرایط مختلف استفاده میکنند. این الگوریتمها میتوانند با آزمایش و خطا، بهترین راهکار برای تصمیمگیری در ترافیک، تشخیص مانع و انتخاب مسیر را بیابند.
در زمینه بازیهای ویدئویی نیز، الگوریتمهای مانند AlphaGo و AlphaStar توانستهاند با استفاده از یادگیری تقویتی، به نتایج فوقالعادهای در بازیهای پیچیده برسند. این الگوریتمها با تحلیل میلیونها حرکت و دریافت بازخورد از محیط، سیاستهای بهینهای برای پیروزی در بازیها پیدا کردهاند.
در زمینه رباتیک نیز، یادگیری تقویتی میتواند به رباتها کمک کند تا حرکات پیچیده را بدون نیاز به برنامهریزی دستی یاد بگیرند. برای مثال، یک ربات میتواند با استفاده از این روش یاد بگیرد چگونه یک شیء را با دقت بردارد یا در محیطی نامنظم حرکت کند. این توانایی به ویژه در کاربردهای صنعتی و پزشکی بسیار ارزشمند است.
آینده یادگیری تقویتی
یادگیری تقویتی همچنان در حال پیشرفت است و پژوهشگران در تلاش هستند تا چالشهای موجود را حل کنند و کاربردهای جدیدی برای این روش پیدا کنند. برخی از زمینههای آیندهنگر شامل:
- یادگیری تقویتی در سیستمهای چندعامل (Multi-Agent Reinforcement Learning) برای حل مشکلات پیچیدهتری مانند مدیریت ترافیک شهری یا شبکههای انرژی.
- کombination of یادگیری تقویتی با یادگیری عمیق و یادگیری با نظارت برای بهبود عملکرد الگوریتمها.
- کاربردهای جدید در زمینههای پزشکی، مانند استفاده از رباتهای جراحی هوشمند که با یادگیری تقویتی میتوانند حرکات دقیقتری انجام دهند.
با پیشرفت فناوری و افزایش قدرت محاسباتی، میتوان انتظار داشت که یادگیری تقویتی در آینده نزدیک در بسیاری از زمینهها کاربردهای جدیدی پیدا کند و به یکی از روشهای اصلی یادگیری ماشین تبدیل شود. برای آشنایی بیشتر با آخرین دستاوردهای هوش مصنوعی و یادگیری تقویتی، میتوانید به مقالات و تحلیلهای ماشین مگ مراجعه کنید.