در دنیای هوش مصنوعی و مدلهای زبانی، یادگیری تقویتی از بازخورد انسانی (Human Feedback Reinforcement Learning یا HFRL) به یکی از روشهای کلیدی تبدیل شده است که به مدلها کمک میکند تا پاسخهای دقیقتر، مفیدتر و نزدیکتر به انتظارات انسان ارائه دهند. این روش که در سالهای اخیر توجه بسیاری از محققان و شرکتهای بزرگ فناوری را به خود جلب کرده است، اساس کار بسیاری از مدلهای پیشرفته امروزی مانند چتباتهای پیشرفته و سیستمهای پاسخگویی مبتنی بر هوش مصنوعی را تشکیل میدهد. اما یادگیری تقویتی از بازخورد انسانی دقیقاً چیست؟ چرا اینقدر مهم است؟ و قبل از اقدام به استفاده از آن، چه نکاتی باید در نظر گرفت؟ در این مقاله به این سوالات پاسخ میدهیم و به بررسی جزئیات این روش میپردازیم.
یادگیری تقویتی از بازخورد انسانی چیست؟
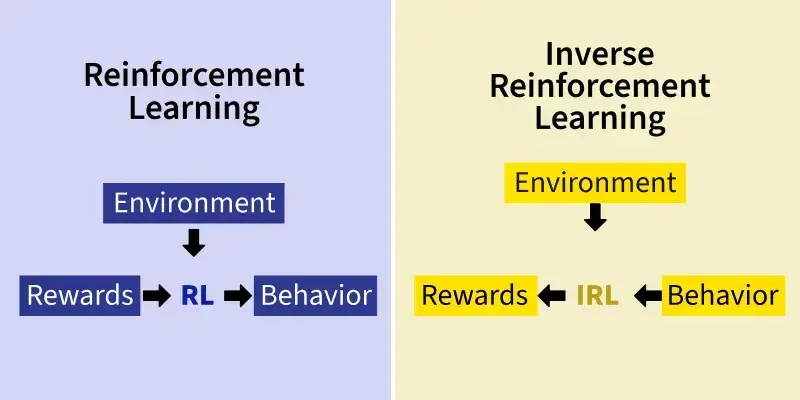
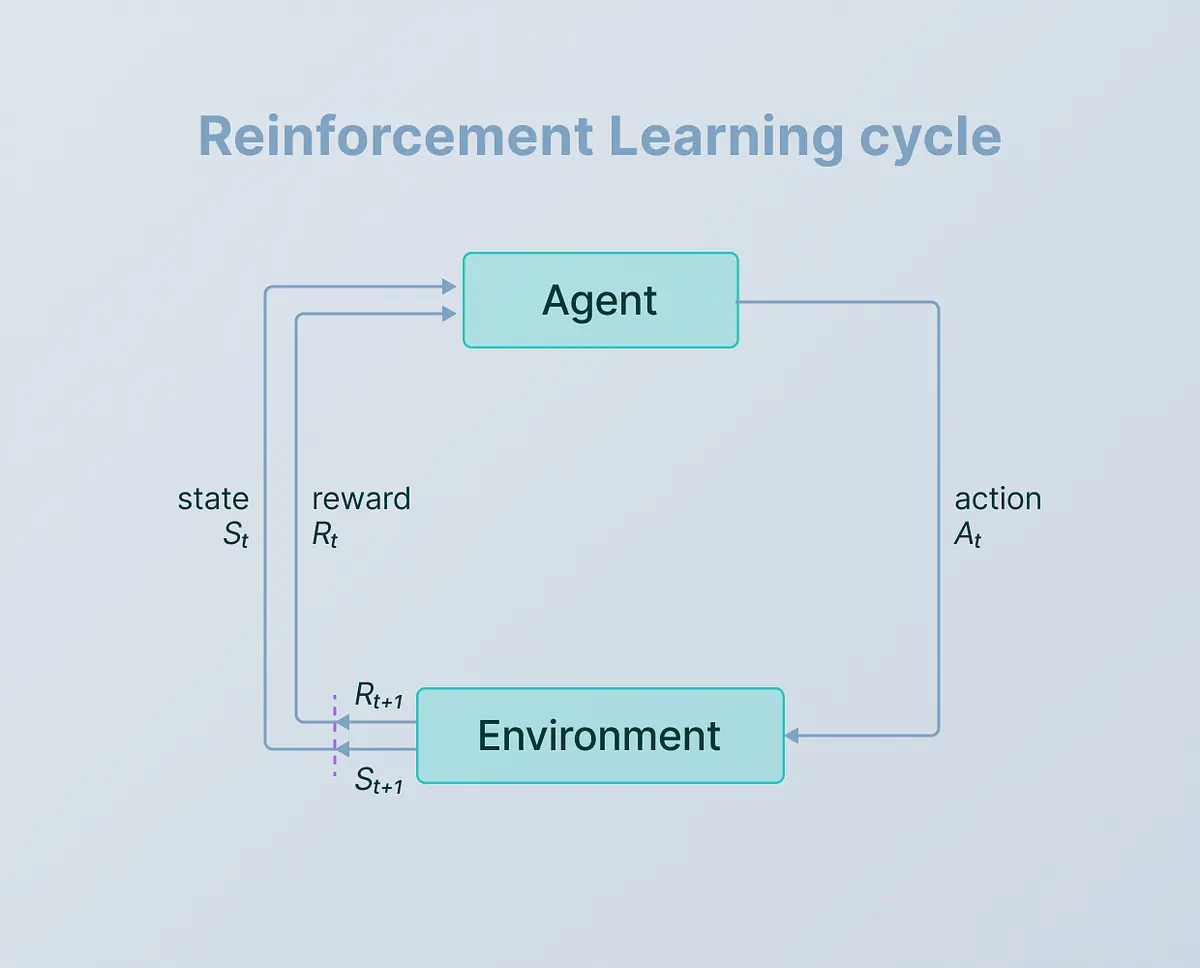
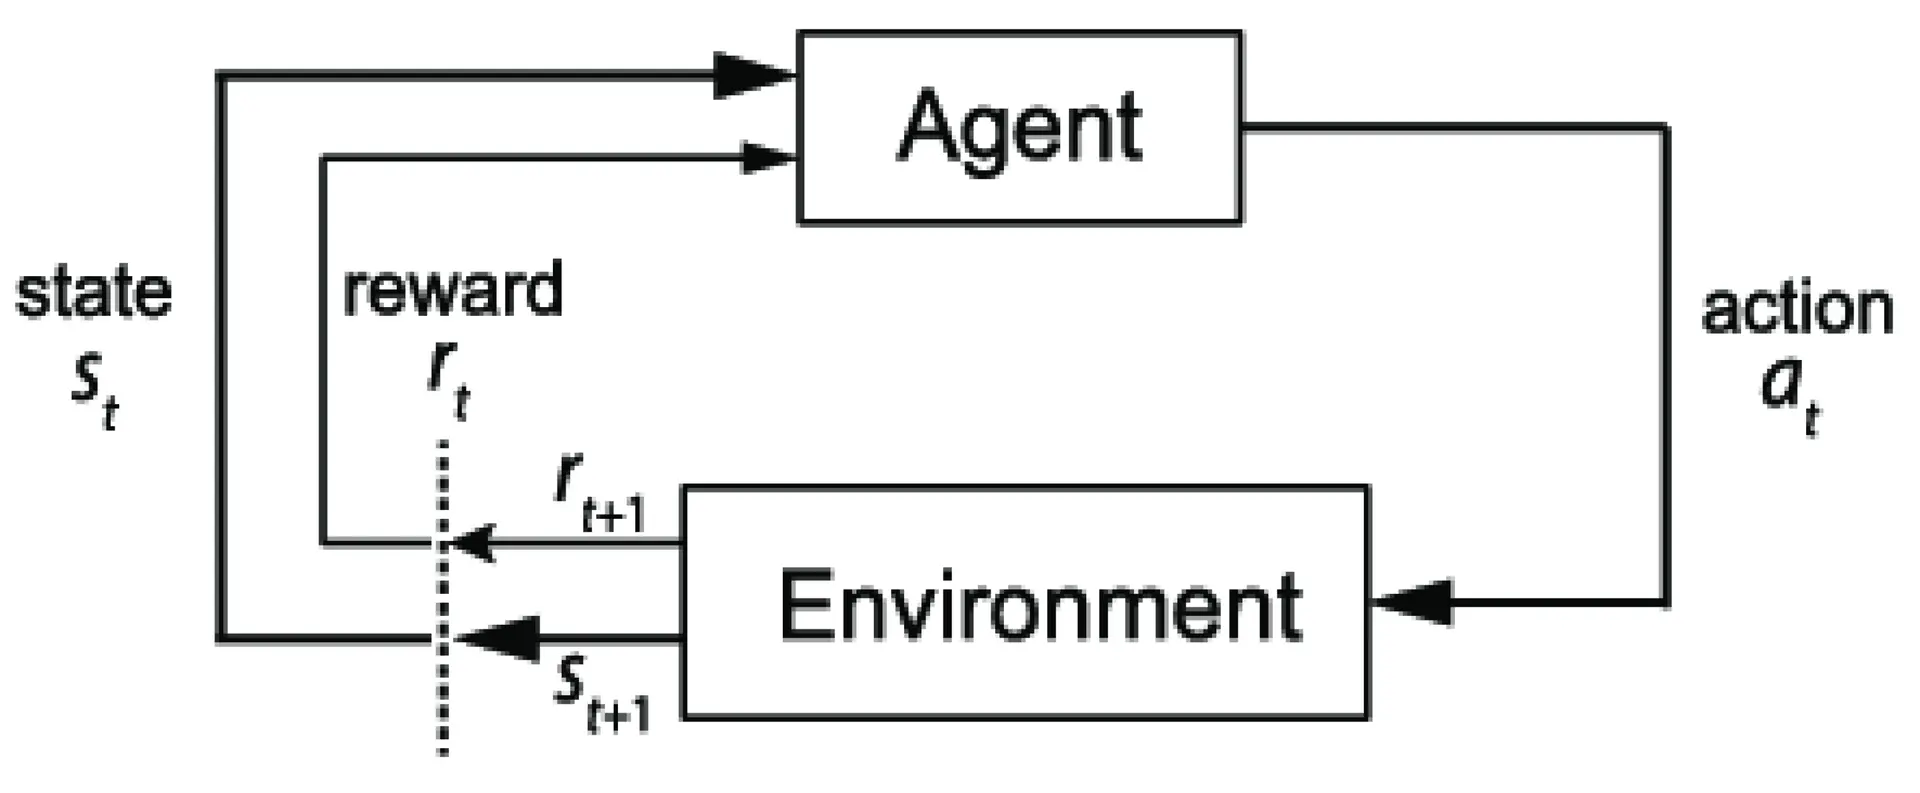
یادگیری تقویتی از بازخورد انسانی یک روش ترکیبی از یادگیری تقویتی (Reinforcement Learning) و یادگیری از دادههای برچسبدار (Supervised Learning) است. در این روش، مدل ابتدا با دادههای آموزشی برچسبدار (مانند جفت سوال و پاسخ صحیح) آموزش میبیند، سپس با استفاده از بازخوردهای انسانی، عملکرد خود را بهبود میبخشد.
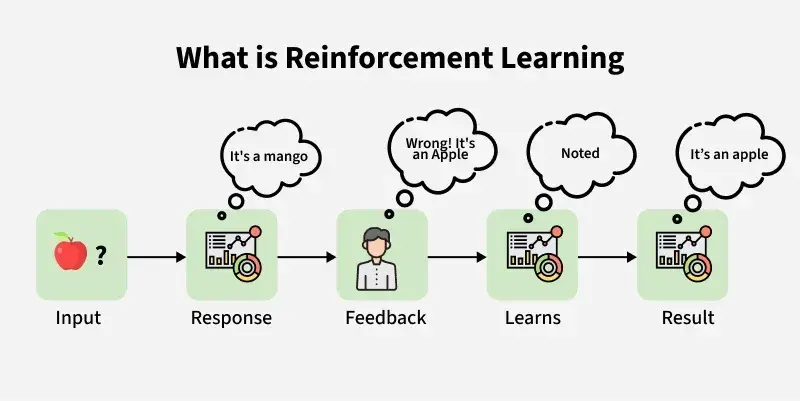
در مرحله اول، مدل با دادههای بزرگ و متنوعی آموزش میبیند تا بتواند پاسخهای اولیه ارائه دهد. سپس، انسانها با ارزیابی پاسخهای مدل، بازخوردهایی مانند “پاسخ صحیح است”، “پاسخ نادرست است”، یا حتی “پاسخ قابل بهبود است” ارائه میدهند. این بازخوردها به مدل کمک میکنند تا با استفاده از الگوریتمهای یادگیری تقویتی، پاسخهای خود را بهینهسازی کند و در نهایت به یک مدل دقیقتر و قابل اعتمادتر تبدیل شود.
این روش به ویژه در زمینههای نیاز به تعامل مستقیم با انسان، مانند چتباتها، سیستمهای پاسخگویی به سوالات، و حتی سیستمهای توصیهگر، بسیار مؤثر است. زیرا در این موارد، دقت و کیفیت پاسخها به شدت وابسته به درک صحیح نیازهای انسانی است.
چرا یادگیری تقویتی از بازخورد انسانی برای مدلهای زبانی مهم است؟
یادگیری تقویتی از بازخورد انسانی به دلیل چند دلیل اساسی، برای مدلهای زبانی بسیار مهم است:
- دقت و کیفیت بالاتر: مدلهای زبانی که با این روش آموزش میبینند، پاسخهای دقیقتر و نزدیکتر به انتظارات انسان ارائه میدهند. این به ویژه در مواردی که نیاز به پاسخهای تخصصی یا دقیق وجود دارد، بسیار مهم است.
- انطباق با نیازهای انسانی: این روش به مدلها اجازه میدهد تا با درک بهتر نیازهای انسان، پاسخهای خود را به صورت دینامیک و انعطافپذیر بهبود بخشند. این ویژگی در سیستمهایی که با انسان تعامل دارند، بسیار حیاتی است.
- کاهش نیاز به دادههای برچسبدار: در روشهای سنتی، نیاز به حجم زیادی از دادههای برچسبدار وجود دارد که تهیه و برچسبگذاری آنها هزینهبر و زمانبر است. اما با استفاده از بازخورد انسانی، مدل میتواند با دادههای کمتر اما با کیفیت بالاتر آموزش ببیند.
- بهبود مداوم: این روش امکان بهبود مداوم مدل را فراهم میآورد، زیرا بازخوردهای انسانی میتوانند به صورت پیوسته جمعآوری و استفاده شوند. این ویژگی به مدلها اجازه میدهد تا با تغییرات نیازهای انسانی، به روز شوند.
به عنوان مثال، در چتباتهای امروزی، استفاده از این روش باعث شده است که پاسخهای ارائه شده نه تنها دقیقتر باشند، بلکه با حساسیت بیشتری به نیازهای کاربر نیز ارائه شوند. این ویژگی به ویژه در زمینههای پزشکی، حقوقی و فنی که نیاز به دقت بالا وجود دارد، بسیار ارزشمند است.
چالشهای یادگیری تقویتی از بازخورد انسانی
در حالی که یادگیری تقویتی از بازخورد انسانی مزایای بسیاری دارد، اما با چالشهایی نیز همراه است که باید قبل از اقدام به استفاده از این روش، به آنها توجه کرد:
- هزینه و زمان: جمعآوری بازخوردهای انسانی و برچسبگذاری آنها هزینهبر و زمانبر است. نیاز به کارکنان ماهر و سیستمهای مناسب برای جمعآوری و پردازش این بازخوردها وجود دارد.
- نوسان در بازخورد: بازخوردهای انسانی ممکن است نوسان داشته باشند، یعنی یک پاسخ ممکن است توسط چند نفر به صورت متفاوت ارزیابی شود. این نوسان میتواند باعث شود که مدل نتواند به یک پاسخ یکسان برسد.
- محدودیتهای فرهنگی و زبانی: بازخوردهای انسانی ممکن است تحت تأثیر فرهنگ، زبان و حتی پیشداوریهای فردی باشند. این موضوع میتواند باعث شود که مدل در درک نیازهای جهانی دچار مشکل شود.
- نیاز به سیستمهای مناسب: برای اجرای موفق این روش، نیاز به سیستمهای مناسب برای جمعآوری، پردازش و استفاده از بازخوردهای انسانی وجود دارد. این سیستمها باید بتوانند دادهها را به صورت مؤثر مدیریت و به مدل ارائه کنند.
به عنوان مثال، در پروژههای بزرگ مانند توسعه چتباتهای پیشرفته، شرکتها نیاز دارند تا تیمهای بزرگی از کارشناسان را برای جمعآوری و تحلیل بازخوردهای انسانی استخدام کنند. این موضوع میتواند هزینههای پروژه را افزایش دهد و زمان اجرای آن را طولانیتر کند.
چگونه میتوان از یادگیری تقویتی از بازخورد انسانی استفاده کرد؟
اگر قصد استفاده از یادگیری تقویتی از بازخورد انسانی را دارید، باید به چند نکته اساسی توجه کنید:
- تعیین اهداف واضح: قبل از شروع، باید اهداف دقیقی برای استفاده از این روش تعیین کنید. آیا هدف بهبود دقت پاسخها است؟ یا افزایش رضایت کاربر؟ یا کاهش هزینههای آموزشی؟ تعیین اهداف واضح کمک میکند تا فرآیند آموزش به درستی طراحی شود.
- انتخاب دادههای مناسب: دادههای آموزشی باید متنوع، دقیق و مرتبط با هدف نهایی باشند. استفاده از دادههای نامناسب میتواند منجر به مدلهایی شود که پاسخهای غیرقابل اعتماد ارائه میدهند.
- سیستم جمعآوری بازخورد: نیاز به یک سیستم مناسب برای جمعآوری بازخوردهای انسانی وجود دارد. این سیستم باید بتواند بازخوردها را به صورت مؤثر جمعآوری و پردازش کند و به مدل ارائه دهد.
- آزمایش و ارزیابی: قبل از استفاده از مدل در محیط واقعی، باید آن را در شرایط آزمایشی ارزیابی کنید. این کمک میکند تا مشکلات احتمالی شناسایی و برطرف شوند.
- به روزرسانی مداوم: یادگیری تقویتی از بازخورد انسانی یک فرآیند مداوم است. باید به صورت پیوسته بازخوردهای جدید را جمعآوری و مدل را به روزرسانی کنید تا بتواند با تغییرات نیازهای انسانی همراه شود.
به عنوان مثال، شرکتهایی مانند OpenAI در توسعه مدلهای زبان مانند GPT، از این روش استفاده کردهاند. آنها با جمعآوری بازخوردهای انسانی از کاربران، مدلهای خود را به صورت مداوم بهبود بخشیدهاند. این رویکرد باعث شده است که مدلها بتوانند پاسخهای دقیقتر و نزدیکتر به نیازهای کاربر ارائه دهند.
آینده یادگیری تقویتی از بازخورد انسانی
یادگیری تقویتی از بازخورد انسانی در آینده نزدیک، نقش مهمتری در توسعه مدلهای زبانی و سیستمهای هوش مصنوعی ایفا خواهد کرد. با پیشرفت فناوریها و افزایش توانایی مدلها در درک و پردازش زبان طبیعی، این روش میتواند به یک ابزار استاندارد برای آموزش مدلهای هوش مصنوعی تبدیل شود.
در آینده، میتوان انتظار داشت که سیستمهای هوش مصنوعی بتوانند با استفاده از بازخوردهای انسانی به صورت خودکار و بدون نیاز به دخالت مستقیم انسان، بهبود یابند. این موضوع میتواند هزینهها را کاهش داده و سرعت توسعه مدلها را افزایش دهد.
همچنین، با پیشرفت روشهای یادگیری تقویتی و افزایش توانایی مدلها در درک زمینههای مختلف، این روش میتواند در زمینههای جدیدی مانند آموزش مدلهای چندزبانه، توسعه سیستمهای توصیهگر شخصیسازی شده و حتی بهبود سیستمهای خودران نیز استفاده شود.
در نهایت، یادگیری تقویتی از بازخورد انسانی نه تنها به بهبود کیفیت مدلهای زبانی کمک میکند، بلکه میتواند به ایجاد سیستمهایی کمک کند که بهتر بتوانند با نیازهای انسانی هماهنگ شوند. این موضوع میتواند در توسعه فناوریهای آینده، مانند هوش مصنوعی عمومی، بسیار مؤثر باشد.
اگر به دنبال اطلاعات بیشتر در زمینههای مرتبط با هوش مصنوعی و مدلهای زبانی هستید، میتوانید به مقالات و تحلیلهای ارائه شده در ماشین مگ مراجعه کنید. این منابع میتوانند به شما کمک کنند تا با آخرین توسعهها و روشهای این حوزه آشنا شوید.