در چند سال گذشته، یکی از مهمترین پیشرفتهای حوزه هوش مصنوعی، ظهور و تکامل مدلهای زبانی بزرگ (Large Language Models یا به اختصار LLMs) بوده است. این مدلها با توانایی تولید متنهای پیچیده و شبیه به انسان، بسیاری از کاربردهای روزمره و حرفهای را تغییر دادهاند. اما مدلهای زبانی بزرگ دقیقاً چیستند؟ چگونه کار میکنند؟ و چرا توانایی تولید متن شبیه انسان دارند؟ در این راهنمای کامل، به بررسی این سوالات میپردازیم و همچنین به شما کمک میکنیم تا با درک بهتر این فناوری، تصمیمات هوشمندانهتری در استفاده از آن بگیرید.
مدلهای زبانی بزرگ چیستند؟
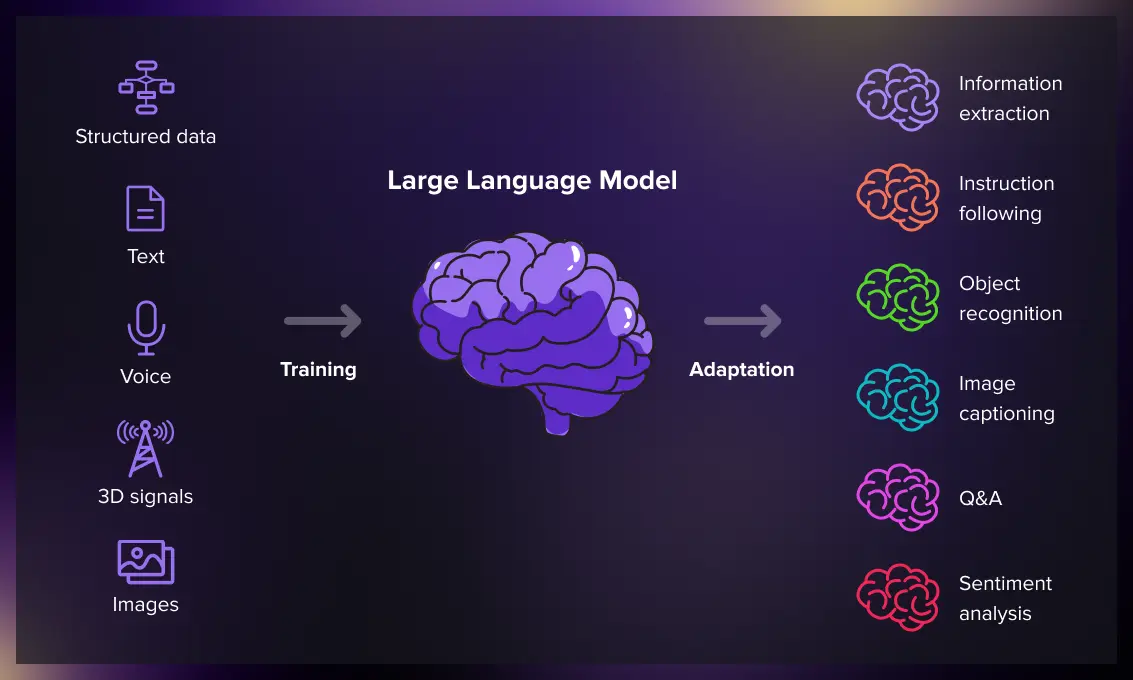
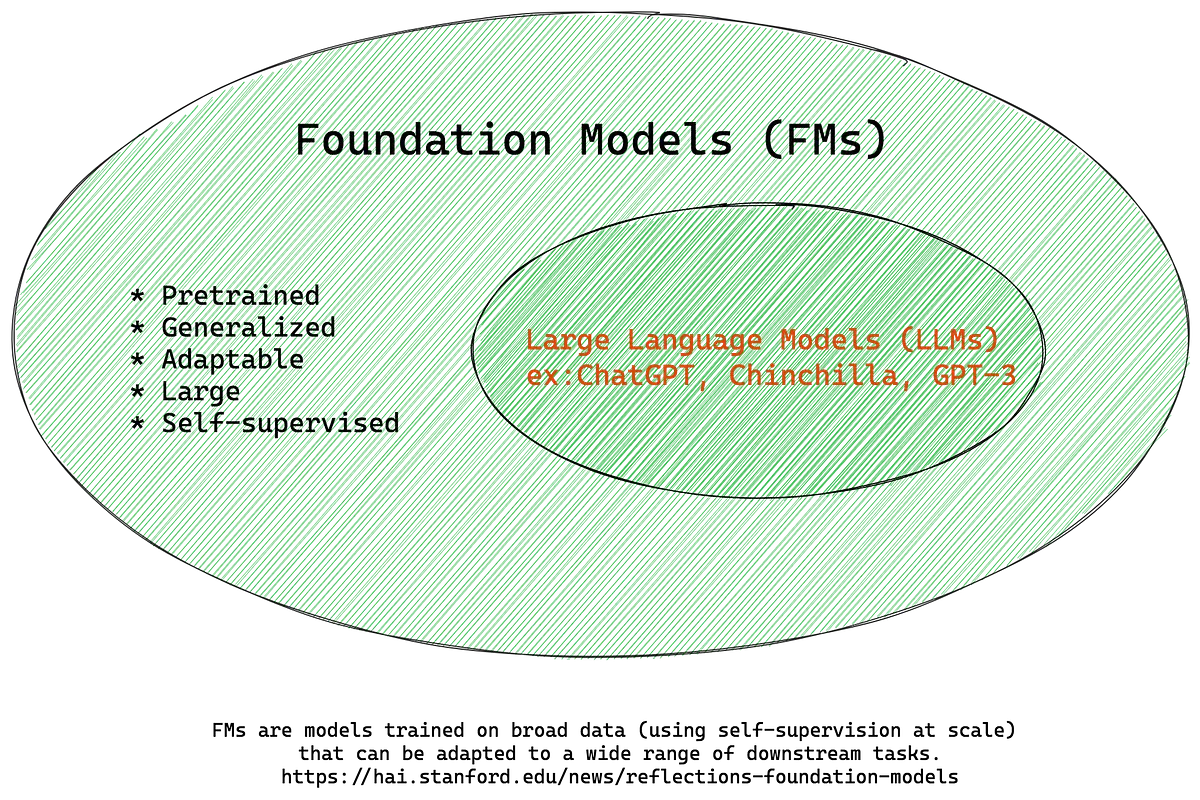
مدلهای زبانی بزرگ، نوعی از مدلهای هوش مصنوعی هستند که بر اساس شبکههای عصبی عمیق (Deep Neural Networks) و به ویژه معماری ترانسفورمر (Transformer) طراحی شدهاند. این مدلها با آموزش بر روی حجم عظیم دادههای متن، توانایی درک و تولید متنهای طبیعی را کسب میکنند. تفاوت اصلی این مدلها با سیستمهای قبلی، در توانایی آنها برای درک زمینه (Context) و تولید متنهای مرتبط و منطقی است.
یکی از نمونههای معروف این مدلها، چتباتهای مبتنی بر هوش مصنوعی مانند ChatGPT هستند که با استفاده از مدلهای زبانی بزرگ، میتوانند پاسخهای متنوع و شبیه به انسان ارائه دهند. اما مدلهای زبانی بزرگ تنها به چتباتها محدود نمیشوند؛ در بسیاری از کاربردهای دیگر مانند ترجمه خودکار، خلاصهسازی متن، تولید کد برنامهنویسی و حتی تحلیل دادهها نیز استفاده میشوند.
چگونه مدلهای زبانی بزرگ کار میکنند؟
برای درک بهتر نحوه عملکرد این مدلها، باید به معماری و روش آموزش آنها نگاه کنیم:
- آموزش با دادههای متنوع: این مدلها با خواندن میلیاردها صفحه متن از منابع مختلف مانند کتابها، مقالات علمی، وبسایتها و حتی شبکههای اجتماعی آموزش میبینند. این دادهها شامل متنهای مختلفی از جمله مقالات علمی، خبرها، داستانها و حتی کدهای برنامهنویسی هستند.
- معماری ترانسفورمر: معماری ترانسفورمر، که در سال ۲۰۱۷ معرفی شد، اساس بسیاری از مدلهای زبانی بزرگ امروزی است. این معماری با استفاده از مکانیسمهای توجه (Attention Mechanisms)، میتواند روابط بین کلمات در یک جمله یا پاراگراف را درک کند و متنهای مرتبط تولید کند.
- پیشبینی کلمه بعدی: یکی از روشهای اصلی آموزش این مدلها، پیشبینی کلمه بعدی در یک جمله است. برای مثال، اگر جملهای مانند «هوش مصنوعی در سالهای اخیر» به مدل داده شود، مدل سعی میکند کلمه بعدی مانند «توسعه»، «کاربردها»، یا «چالشها» را پیشبینی کند. این روش باعث میشود مدل یاد بگیرد که چگونه متنهای طبیعی و مرتبط تولید کند.
- تuning و fine-tuning: پس از آموزش اولیه با دادههای عمومی، این مدلها میتوانند با دادههای خاصتری آموزش داده شوند (تuning) یا حتی برای کاربردهای خاص بهینهسازی شوند (fine-tuning). این مرحله باعث میشود مدلها در زمینههای خاص مانند پزشکی، حقوق یا برنامهنویسی عملکرد بهتری داشته باشند.
چگونه متن شبیه انسان تولید میکنند؟
توانایی تولید متن شبیه انسان یکی از ویژگیهای برجسته مدلهای زبانی بزرگ است. اما چگونه این مدلها میتوانند متنهایی تولید کنند که به نظر طبیعی و مرتبط میرسند؟ پاسخ در چند عامل کلیدی نهفته است:
۱. درک زمینه و ارتباطات بین کلمات
مدلهای زبانی بزرگ با استفاده از مکانیسمهای توجه، میتوانند روابط بین کلمات در یک جمله یا پاراگراف را درک کنند. برای مثال، اگر جملهای مانند «ماشینهای خودران در آینده نزدیک» تولید شود، مدل میتواند کلمات مرتبط مانند «تکنولوژی»، «امنیت»، یا «چالشها» را در متن بعدی استفاده کند. این درک زمینه باعث میشود متن تولید شده منطقی و مرتبط به نظر برسد.
۲. یادگیری از دادههای متنوع
این مدلها با خواندن میلیاردها صفحه متن از منابع مختلف، یاد میگیرند که چگونه کلمات در جملهها و پاراگرافها استفاده میشوند. این یادگیری شامل درک ساختار جمله، استفاده از واژگان مناسب و حتی نویسهشناسی متن است. برای مثال، یک مدل زبانی بزرگ میتواند تفاوت بین استفاده از «شما» در یک متن رسمی و «تو» در یک متن غیررسمی را تشخیص دهد.
۳. پیشبینی احتمالی کلمات
مدلهای زبانی بزرگ با استفاده از الگوریتمهای پیشبینی احتمالی، سعی میکنند کلمهای را انتخاب کنند که احتمال بیشتری دارد در ادامه متن استفاده شود. این روش باعث میشود متن تولید شده طبیعی و مرتبط به نظر برسد. برای مثال، اگر جملهای مانند «هوش مصنوعی میتواند» تولید شود، مدل ممکن است کلماتی مانند «مسائل پیچیده را حل کند»، «به انسان کمک کند»، یا «تغییرات بزرگی ایجاد کند» را پیشبینی کند.
۴. استفاده از دادههای آموزشی با کیفیت بالا
کیفیت دادههای آموزشی یکی از عوامل مهم در تولید متن شبیه انسان است. مدلهایی که با دادههای دقیق، مرتبط و متنوع آموزش میبینند، توانایی بیشتری در تولید متنهای طبیعی دارند. برای مثال، استفاده از متنهای علمی برای آموزش مدلها در زمینههای علمی، باعث میشود پاسخهای آنها دقیقتر و مرتبطتر باشد.
چالشها و محدودیتهای مدلهای زبانی بزرگ
در حالی که مدلهای زبانی بزرگ تواناییهای زیادی دارند، اما همچنان با چالشها و محدودیتهایی روبرو هستند:
- نقص در درک عمیق: این مدلها میتوانند متنهای مرتبط تولید کنند، اما درک عمیق و واقعی از مفهوم متن را ندارند. برای مثال، ممکن است یک مدل زبانی بزرگ بتواند یک مقاله علمی را خلاصه کند، اما نمیتواند درک عمیقی از مفاهیم علمی آن داشته باشد.
- نقص در دقت: در برخی موارد، مدلها ممکن است اطلاعات نادرست یا بیربط تولید کنند، به ویژه در زمینههای تخصصی یا زمانی که دادههای آموزشی کافی ندارند.
- محدودیت در تولید متنهای خلاق: اگرچه این مدلها میتوانند متنهای خلاقانه تولید کنند، اما هنوز نمیتوانند به سطح خلاقیت انسانی برسند. برای مثال، تولید داستانهای پیچیده یا شعر با کیفیت بالا هنوز چالشبرانگیز است.
- محدودیت در درک زبانهای غیررسمی: مدلها ممکن است در درک و تولید متنهای غیررسمی، مانند زبانهای محلی یا گویشها، با چالشهایی روبرو شوند.
کاربردهای مدلهای زبانی بزرگ
مدلهای زبانی بزرگ در بسیاری از زمینهها کاربرد دارند و میتوانند به بهبود کارایی و کیفیت در مختلف حوزهها کمک کنند:
- چتباتها و دستیاران مجازی: استفاده از مدلهای زبانی بزرگ در چتباتها و دستیاران مجازی مانند Siri، Alexa و ChatGPT، تجربه کاربری را بهبود بخشیده است.
- ترجمه خودکار: مدلهای زبانی بزرگ در سیستمهای ترجمه خودکار مانند Google Translate استفاده میشوند و کیفیت ترجمه را افزایش دادهاند.
- تولید محتوا: این مدلها میتوانند در تولید مقالات، گزارشها، داستانها و حتی کدهای برنامهنویسی کمک کنند.
- تحلیل دادهها: مدلهای زبانی بزرگ میتوانند در تحلیل دادههای متن، مانند بررسی نظرات مشتریان یا خلاصهسازی گزارشها، استفاده شوند.
- آموزش و یادگیری: این مدلها میتوانند در تولید مواد آموزشی، پاسخ به سوالات دانشآموزان و حتی طراحی آزمونها کمک کنند.
برای اطلاعات بیشتر در مورد کاربردهای پیشرفته هوش مصنوعی و مدلهای زبانی بزرگ، میتوانید به مقالات مرتبط در ماشین مگ مراجعه کنید.
چگونه میتوانیم از مدلهای زبانی بزرگ استفاده کنیم؟
استفاده از مدلهای زبانی بزرگ نیازمند درک بهتری از تواناییها و محدودیتهای آنها است. در این بخش، چند نکته مهم برای استفاده مؤثر از این مدلها ارائه میدهیم:
۱. انتخاب مدل مناسب
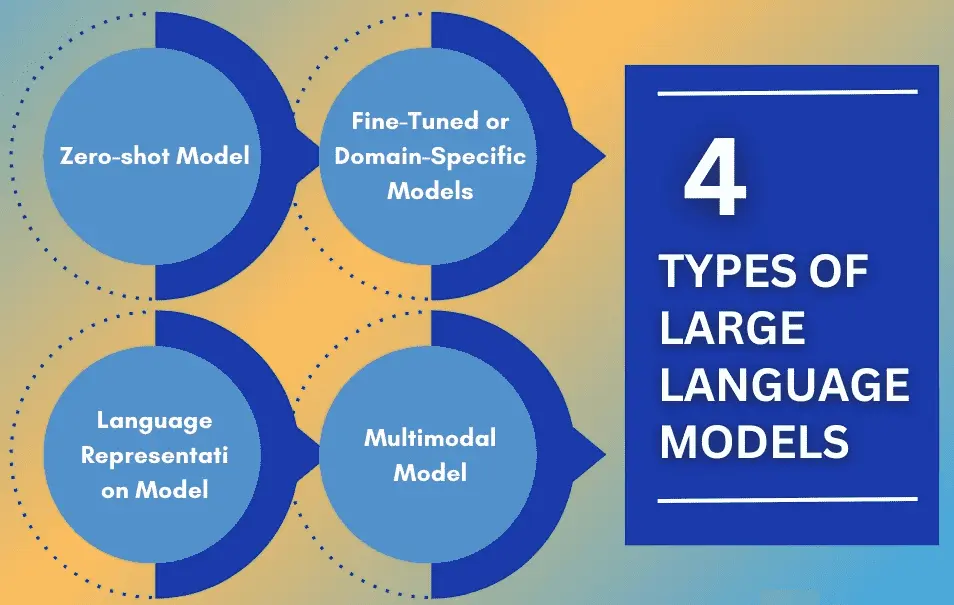
هر مدل زبانی بزرگ برای کاربردهای خاص طراحی شده است. برای مثال، مدلهایی مانند BERT برای تحلیل متن و مدلهایی مانند GPT برای تولید متن استفاده میشوند. انتخاب مدل مناسب بر اساس نیاز شما میتواند کیفیت نتایج را بهبود بخشد.
۲. استفاده از دادههای آموزشی مناسب
اگر میخواهید مدل را برای کاربرد خاصی بهینهسازی کنید، استفاده از دادههای آموزشی مرتبط و با کیفیت بالا ضروری است. این دادهها میتوانند شامل متنهای تخصصی، نمونههای کاربردی یا حتی بازخوردهای کاربران باشند.
۳. ارزیابی نتایج
همیشه نتایج تولید شده توسط مدل را ارزیابی کنید. این مدلها ممکن است در برخی موارد اطلاعات نادرست یا بیربط تولید کنند، بنابراین بررسی و تأیید نتایج ضروری است.
۴. استفاده از ابزارهای تکمیلی
استفاده از ابزارهای تکمیلی مانند ویرایشگرهای متن، سیستمهای مدیریت محتوا و حتی ابزارهای تحلیل داده میتواند کمک کند تا نتایج بهتری حاصل شود. برای مثال، استفاده از ابزارهای ویرایشگر متن میتواند کیفیت متن تولید شده توسط مدل را بهبود بخشد.
نکات پایانی برای تصمیمگیری بهتر
مدلهای زبانی بزرگ یکی از پیشرفتهای مهم در حوزه هوش مصنوعی هستند و میتوانند در بسیاری از زمینهها کاربرد داشته باشند. اما برای استفاده مؤثر از این مدلها، باید تواناییها و محدودیتهای آنها را درک کنید. در این راهنمای کامل، سعی کردیم به سوالات اصلی در مورد مدلهای زبانی بزرگ پاسخ دهیم و راهنمایی برای استفاده بهتر از آنها ارائه دهیم.
با توجه به پیشرفتهای روزافزون در این حوزه، میتوان انتظار داشت که مدلهای زبانی بزرگ در آینده نزدیک کاربردهای بیشتری پیدا کنند و کیفیت تولید متن آنها نیز بهبود یابد. بنابراین، داشتن اطلاعات دقیق و روز در مورد این فناوری میتواند به شما کمک کند تا تصمیمات هوشمندانهتری در استفاده از آن بگیرید.