در دنیای امروزی که دادهها به یکی از مهمترین داراییهای سازمانها و شرکتها تبدیل شدهاند، مفهوم داده ناشناس به یکی از موضوعات کلیدی در بحث حریم خصوصی و امنیت اطلاعات تبدیل شده است. اما چه چیزی داده ناشناس میکند؟ آیا ناشناسسازی همیشه میتواند از حریم خصوصی محافظت کند؟ و چگونه میتوانیم از این روش برای حفظ اطلاعات شخصی استفاده کنیم؟ این سوالات را در این راهنما به صورت ساده بررسی میکنیم.
داده ناشناس چیست؟
داده ناشناس به دادههایی گفته میشود که به گونهای پردازش شدهاند که دیگر امکان پیوند دادن آنها به فرد یا منبع اصلی آنها وجود نداشته باشد. این فرایند معمولاً شامل تغییر یا حذف اطلاعات شخصی مانند نام، شماره ملی، آدرس یا هر گونه شناسهای است که میتواند فرد را شناسایی کند. هدف از ناشناسسازی این است که بتوان از دادهها برای تحلیلها و تحقیقات استفاده کرد بدون این که خطر افشای اطلاعات شخصی وجود داشته باشد.
برای مثال، اگر یک شرکت دادههای مشتریان خود را برای تحلیل رفتار خرید جمعآوری کرده باشد، ممکن است نیاز داشته باشد که این دادهها را ناشناس کند تا بتواند از آنها برای بهبود خدمات استفاده کند بدون این که اطلاعات شخصی مشتریان در معرض خطر قرار گیرد.
چگونه دادهها ناشناس میشوند؟
ناشناسسازی دادهها میتواند با روشهای مختلفی انجام شود. برخی از روشهای رایج عبارتند از:
- حذف مستقیم اطلاعات شخصی: در این روش، اطلاعاتی مانند نام، شماره تلفن یا آدرس از دادهها حذف میشوند. این روش سادهترین شکل ناشناسسازی است، اما ممکن است در برخی موارد اطلاعات کافی برای تحلیل باقی نماند.
- کدگذاری یا رمزگذاری: اطلاعات شخصی با استفاده از کدهای جایگزین یا رمزگذاری جایگزین میشوند. برای مثال، نامها با شمارههای تصادفی جایگزین میشوند.
- تجزیه و تحلیل آماری: در این روش، دادهها به گونهای پردازش میشوند که فقط اطلاعات جمعی و آماری قابل دسترسی باشد، نه اطلاعات فردی.
- استفاده از تکنیکهای پیشرفته: روشهایی مانند استفاده از بلوکهای داده ناشناس (Anonymized Data Blocks) یا تکنیکهای یادگیری ماشین برای ناشناسسازی دادهها استفاده میشوند.
هر یک از این روشها مزایا و معایب خود را دارند و انتخاب روش مناسب بستگی به نوع دادهها و هدف از ناشناسسازی دارد.
آیا ناشناسسازی همیشه از حریم خصوصی محافظت میکند؟
اگرچه ناشناسسازی دادهها یکی از روشهای موثری برای محافظت از حریم خصوصی است، اما این روش همیشه تضمین نمیکند که دادهها کاملاً امن باشند. در واقع، در برخی موارد، دادههای ناشناس شده میتوانند با استفاده از تکنیکهای پیشرفته تحلیل، دوباره شناسایی شوند. این موضوع به عنوان “تکرار شناسایی” (Re-identification) شناخته میشود.
برای مثال، اگر دادههای پزشکی یک بیمار شامل اطلاعاتی مانند سن، جنسیت، بیماری و کد پستی باشد، حتی با ناشناسسازی نام بیمار، ممکن است با استفاده از دادههای دیگری مانند اطلاعات جغرافیایی یا زمانبندی، فرد خاصی شناسایی شود. بنابراین، ناشناسسازی باید به گونهای انجام شود که خطر شناسایی مجدد به حداقل برسد.
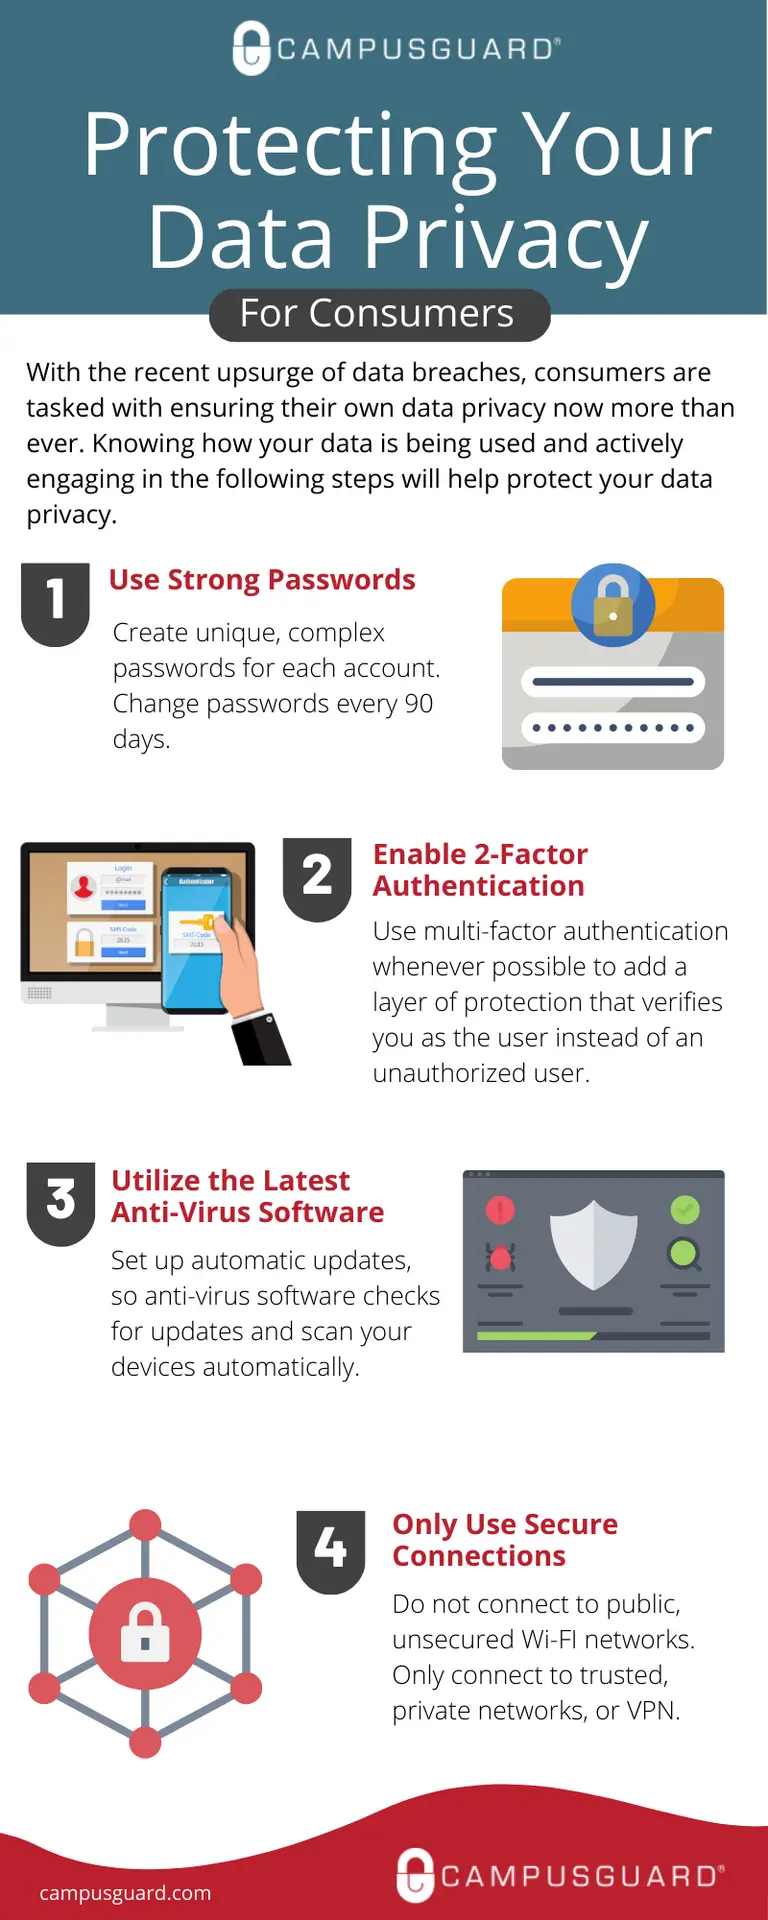
راهنمای ساده برای ناشناسسازی دادهها
اگر شما نیز قصد دارید دادههای خود را ناشناس کنید، این راهنما به شما کمک میکند تا از روشهای مناسب استفاده کنید:
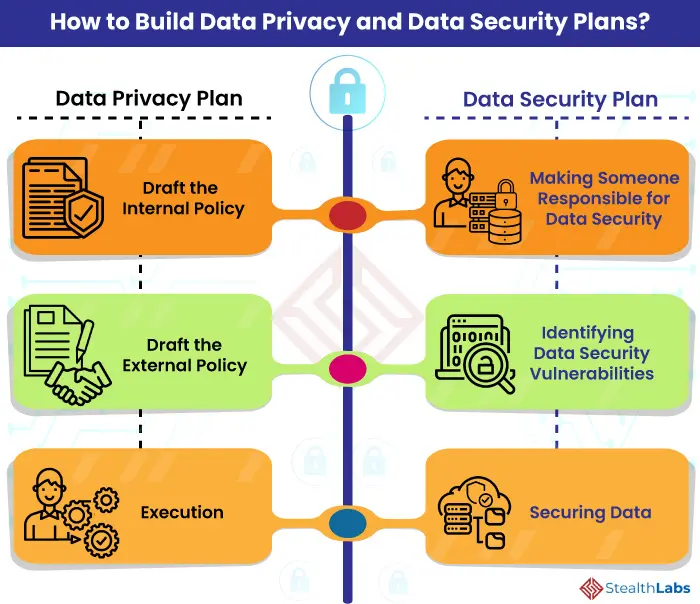
- شناسایی دادههای شخصی: ابتدا باید تمام دادههای شخصی را در مجموعه دادههای خود شناسایی کنید. این شامل نامها، شمارههای تماس، آدرسها و هر گونه اطلاعاتی است که میتواند فرد را شناسایی کند.
- انتخاب روش مناسب: بسته به نوع دادهها و هدف از ناشناسسازی، روش مناسب را انتخاب کنید. برای مثال، اگر دادهها برای تحلیل آماری استفاده میشوند، ممکن است روشهای آماری مناسبتر باشند.
- استفاده از ابزارهای مناسب: ابزارهای مختلفی برای ناشناسسازی دادهها وجود دارند. برخی از این ابزارها شامل کدهای منبع باز مانند ARX یا ابزارهای تجاری مانند IBM InfoSphere هستند.
- آزمایش و ارزیابی: پس از ناشناسسازی، باید دادهها را آزمایش کنید تا مطمئن شوید که هیچ اطلاعات شخصی باقی نمانده است و دادهها همچنان برای تحلیل مفید هستند.
- بهروزرسانی مداوم: با تغییر قوانین و تکنیکهای جدید، باید روشهای ناشناسسازی خود را بهروزرسانی کنید تا همچنان از دادهها محافظت شود.
همچنین، توجه به استانداردهای بینالمللی مانند GDPR (General Data Protection Regulation) در اروپا یا قوانین حریم خصوصی در کشور خود میتواند به شما کمک کند تا روشهای مناسبتری برای ناشناسسازی انتخاب کنید.
چالشهای ناشناسسازی دادهها
ناشناسسازی دادهها با چالشهایی همراه است که باید به آنها توجه کرد:
- کیفیت داده: ناشناسسازی ممکن است باعث کاهش کیفیت دادهها شود، به ویژه اگر اطلاعات مهم برای تحلیل حذف شوند.
- کارایی: برخی از روشهای ناشناسسازی ممکن است زمانبر یا پیچیده باشند و نیاز به منابع بیشتری داشته باشند.
- دقت: ناشناسسازی باید به گونهای انجام شود که دادهها همچنان قابل استفاده برای تحلیل باشند، در غیر این صورت ممکن است اطلاعات ارزشمندی از دست برود.
- تغییرات قانونی: قوانین مربوط به حریم خصوصی و دادهها در حال تغییر هستند و باید با آنها هماهنگ باشید.
با درک این چالشها و استفاده از روشهای مناسب، میتوانید دادههای خود را به صورت امن ناشناس کنید و از آنها برای تحلیلها استفاده کنید.
نکات پایانی
ناشناسسازی دادهها یک روش مؤثر برای محافظت از حریم خصوصی و استفاده از دادهها برای تحلیلها است، اما باید با دقت انجام شود. انتخاب روش مناسب، استفاده از ابزارهای مناسب و آزمایش مداوم میتواند به شما کمک کند تا دادههای خود را به صورت امن ناشناس کنید.
اگر به دنبال اطلاعات بیشتر در مورد تکنولوژیها و روشهای نوین در حوزه دادهها و حریم خصوصی هستید، میتوانید در ماشین مگ مقالات مرتبط را مطالعه کنید.