در دنیای امروزی که دادهها به عنوان «نفت جدید» شناخته میشوند، کیفیت و صحت اطلاعات ورودی به مدلهای هوش مصنوعی نقش تعیینکنندهای در عملکرد و دقت آنها دارد. اما گاهی دادههای آلوده یا «مسموم» وارد سیستم میشوند و باعث میشوند مدلها به جای یادگیری صحیح، رفتارهای غیرمنتظره یا حتی مخرب از خود نشان دهند. این پدیده که به آن مسمومسازی داده (Data Poisoning) گفته میشود، یکی از تهدیدهای جدی در توسعه و آموزش مدلهای هوش مصنوعی محسوب میشود. در این راهنما، به بررسی دقیق این مفهوم، نحوه عملکرد آن، تأثیرات مخرب آن بر مدلها و راهکارهای پیشگیری و مقابله با آن میپردازیم.
مسمومسازی داده چیست؟
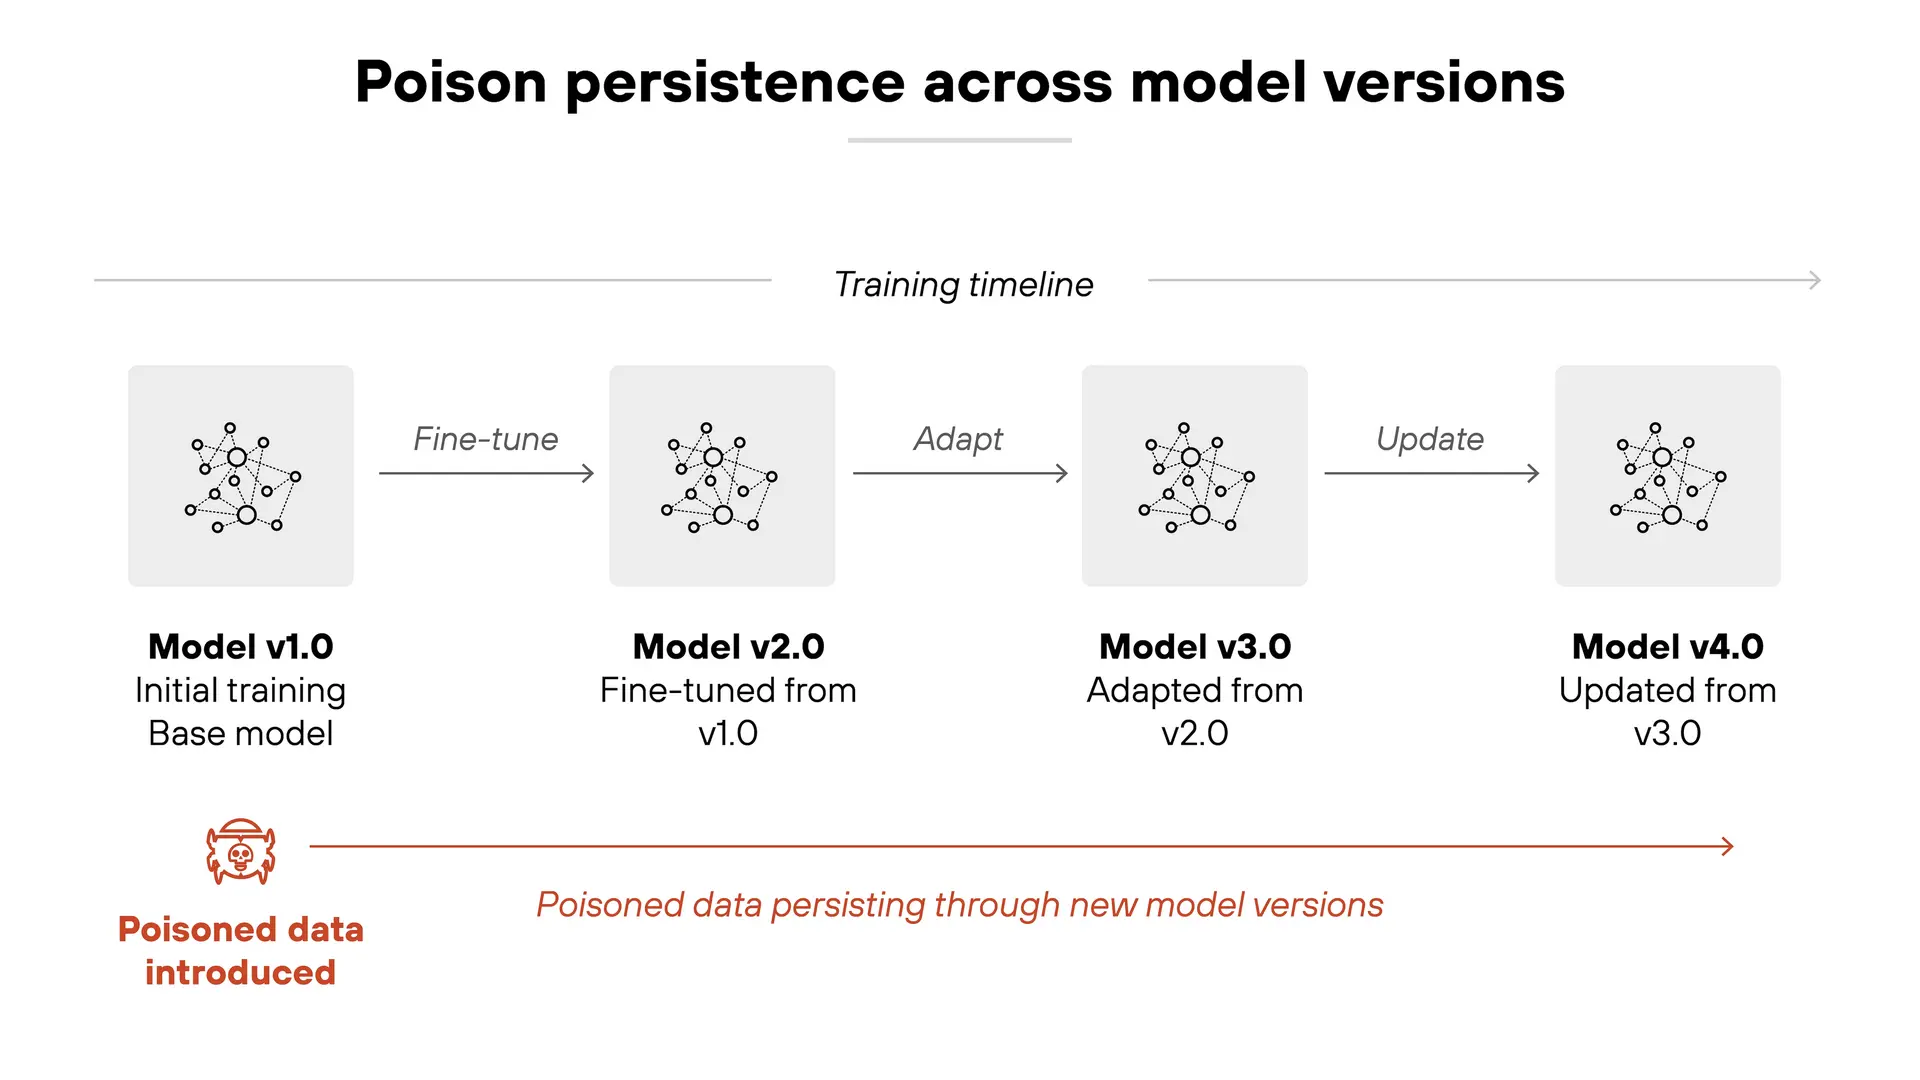
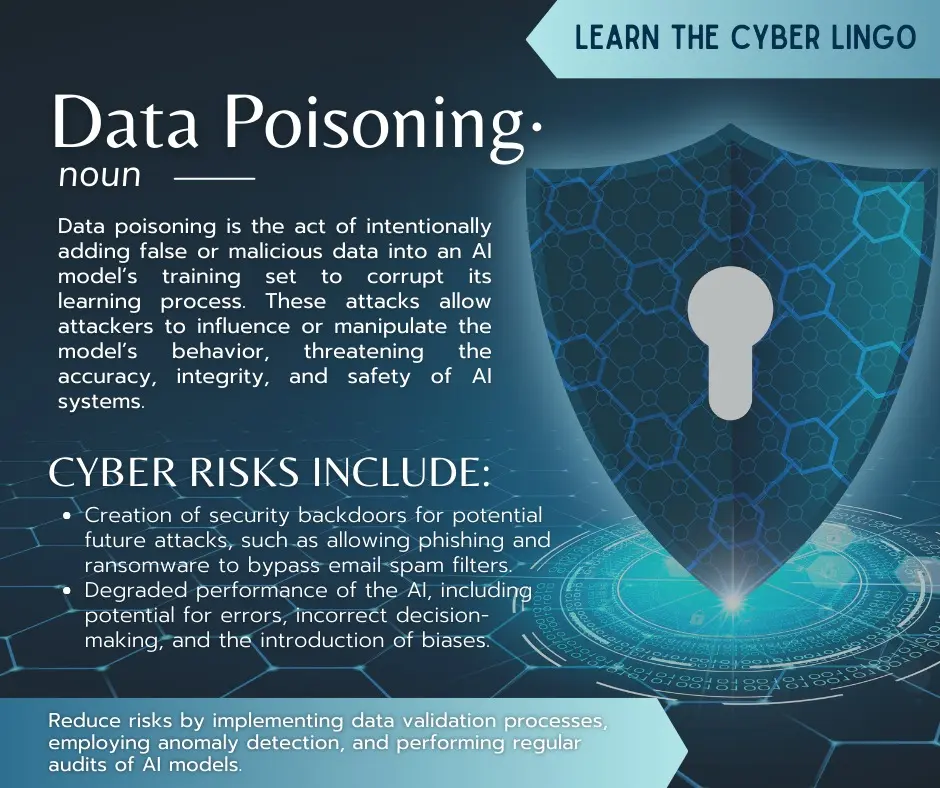
مسمومسازی داده به فرایندی گفته میشود که در آن دادههای آلوده یا غیراصیل به مجموعه آموزشی مدل هوش مصنوعی اضافه میشوند تا عملکرد مدل را به صورت عمدی یا غیرعمدی مختل کنند. این آلودگی میتواند از طریق تغییرات کوچک یا بزرگ در دادهها ایجاد شود، مانند:
- اضافه کردن دادههای نادرست یا غیرمعمول به مجموعه آموزشی
- تغییر برچسبهای دادهها (Label Flipping) به منظور گمراه کردن مدل
- اضافه کردن دادههای تکراری یا غیرمعمول برای ایجاد نویز در یادگیری
- استفاده از دادههای مصنوعی یا ساختهشده برای تغییر الگوی یادگیری
هدف از مسمومسازی داده میتواند متفاوت باشد، از ایجاد خطاهای سیستماتیک در مدل تا تغییر رفتار آن به نفع یک گروه خاص یا حتی سرقت اطلاعات حساس.
چگونه مسمومسازی داده آموزش مدل هوش مصنوعی را مختل میکند؟
مسمومسازی داده میتواند به چندین روش مختلف آموزش مدل هوش مصنوعی را تحت تأثیر قرار دهد:
۱. کاهش دقت مدل
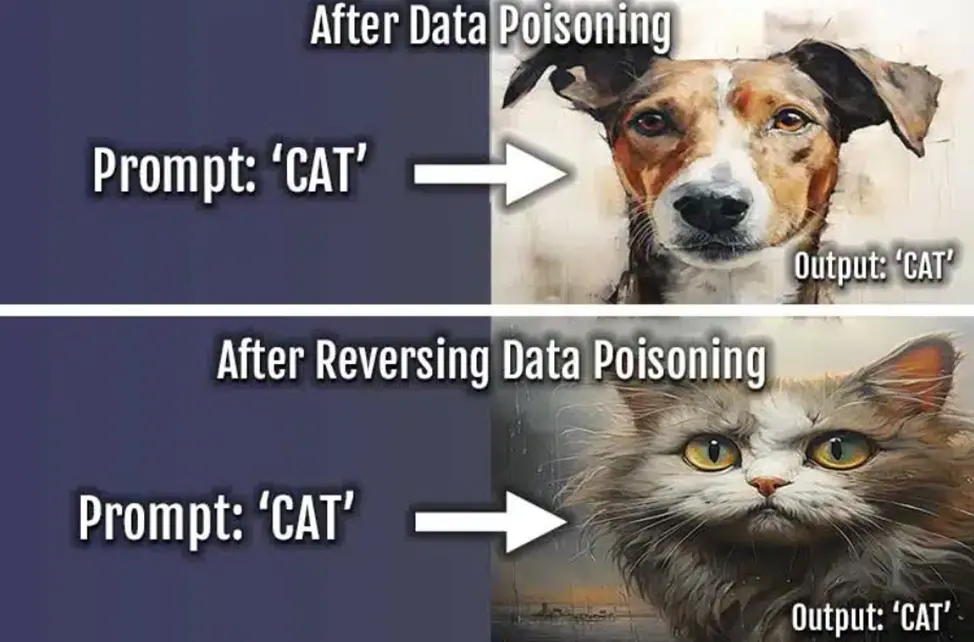
وقتی دادههای آلوده وارد مجموعه آموزشی میشوند، مدل شروع به یادگیری الگوهای نادرست میکند. این امر باعث میشود که دقت پیشبینیهای مدل در دادههای واقعی کاهش یابد. برای مثال، در یک مدل تشخیص تصویر، اگر دادههای آلودهای با برچسبهای نادرست وارد شود، مدل ممکن است اشیاء را به اشتباه تشخیص دهد.
۲. ایجاد بیاعتمادی به مدل
اگر مدل در دادههای واقعی عملکرد ضعیفی داشته باشد، کاربران و توسعهدهندگان ممکن است به نتایج آن اعتماد نکنند. این موضوع در کاربردهای حساس مانند تشخیص بیماریها یا سیستمهای خودران میتواند خطرناک باشد.
۳. تغییر رفتار مدل به نفع مهاجم
در برخی موارد، مهاجم میتواند دادههای آلودهای وارد کند که باعث میشود مدل به نفع خود او عمل کند. برای مثال، در سیستمهای توصیهگر، میتوان دادههای آلودهای اضافه کرد که باعث شود مدل محصولات خاصی را به کاربران پیشنهاد دهد.
۴. افزایش هزینههای محاسباتی
دادههای آلوده میتوانند باعث شوند مدل برای رسیدن به دقت مورد نظر، زمان بیشتری نیاز داشته باشد یا حتی به دادههای بیشتری برای آموزش نیاز داشته باشد. این موضوع هزینههای محاسباتی و زمان را افزایش میدهد.
چگونه میتوان از مسمومسازی داده جلوگیری کرد؟
پیشگیری از مسمومسازی داده نیازمند یک رویکرد چندلایه است که شامل مراحل مختلف از جمعآوری داده تا ارزیابی مدل میشود. برخی از راهکارهای کلیدی عبارتند از:
۱. تصفیه و پاکسازی دادهها
یکی از مهمترین مراحل در آموزش مدل، پاکسازی دادهها است. استفاده از تکنیکهای مختلف مانند:
- تشخیص و حذف دادههای تکراری یا غیرمعمول
- بررسی برچسبهای دادهها و تصحیح خطاها
- استفاده از الگوریتمهای تشخیص دادههای آلوده
میتواند در کاهش تأثیر مسمومسازی داده مؤثر باشد.
۲. استفاده از دادههای معتبر و منبعسنجی
دادههای آموزشی باید از منابع معتبر و قابل اعتماد جمعآوری شوند. استفاده از دادههای باز (Open Data) بدون بررسی دقیق میتواند خطر مسمومسازی را افزایش دهد. همچنین، استفاده از دادههای داخلی سازمان که تحت کنترل هستند، میتواند ریسک را کاهش دهد.
۳. ارزیابی مداوم مدل
پس از آموزش مدل، باید آن را با دادههای تستی که از منابع مختلف و مستقل جمعآوری شدهاند، ارزیابی کرد. این ارزیابی باید شامل بررسی دقت مدل در دادههای مختلف و شناسایی هرگونه رفتار غیرمعمول باشد.
۴. استفاده از تکنیکهای ضد مسمومسازی
تکنیکهایی مانند:
- استفاده از روشهای رباتیک (Robust) در آموزش مدل که به دادههای آلوده حساسیت کمتری دارند
- کاربرد الگوریتمهای تشخیص دادههای آلوده در زمان واقعی
- استفاده از مدلهای فدرال (Federated Learning) که دادهها در سرور مرکزی جمعآوری نمیشوند
میتوانند در مقابله با مسمومسازی داده مؤثر باشند.
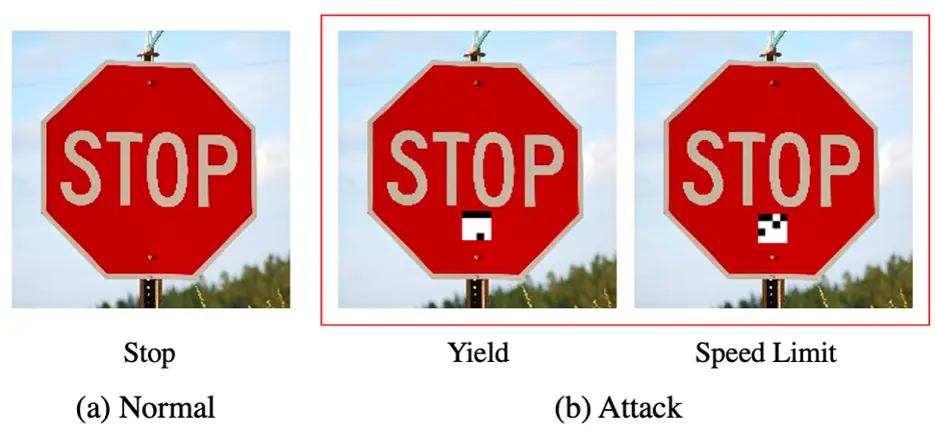
مسمومسازی داده در دنیای واقعی
مسمومسازی داده در دنیای واقعی میتواند تأثیرات جدی داشته باشد. برای مثال:
- در سیستمهای توصیهگر، دادههای آلوده میتوانند باعث شوند محصولات خاصی به کاربران پیشنهاد شود که ممکن است به نفع یک شرکت خاص باشد.
- در سیستمهای تشخیص چهره، دادههای آلوده میتوانند باعث شوند مدل اشخاص را به اشتباه شناسایی کند.
- در سیستمهای خودران، دادههای آلوده میتوانند باعث شوند خودروها رفتارهای غیرمنتظرهای از خود نشان دهند.
این موارد نشان میدهند که چگونه مسمومسازی داده میتواند امنیت، دقت و اعتماد به سیستمهای هوش مصنوعی را تحت تأثیر قرار دهد.
چگونه میتوان به مدلهای مسمومشده پاسخ داد؟
اگر مدل شما تحت تأثیر مسمومسازی داده قرار گرفته باشد، باید اقدامات زیر را انجام دهید:
- مجموعه دادههای آموزشی را دوباره بررسی و دادههای آلوده را شناسایی و حذف کنید.
- از روشهای پاکسازی داده استفاده کنید تا دادههای آلوده را تصحیح یا حذف کنید.
- مدل را با دادههای جدید و معتبر دوباره آموزش دهید.
- از تکنیکهای ضد مسمومسازی استفاده کنید تا مدل در برابر دادههای آلوده مقاومتر شود.
در برخی موارد، ممکن است لازم باشد که مدل را از ابتدا با دادههای جدید و پاکسازیشده آموزش دهید.
نکات پایانی و راهنماییهای کاربردی
مسمومسازی داده یک تهدید جدی برای مدلهای هوش مصنوعی است، اما با استفاده از روشهای مناسب میتوان از آن جلوگیری کرد یا تأثیر آن را کاهش داد. برخی از نکات کاربردی برای کاربران و توسعهدهندگان:
- همیشه دادههای آموزشی را از منابع معتبر و قابل اعتماد جمعآوری کنید.
- قبل از آموزش مدل، دادهها را با دقت بررسی و پاکسازی کنید.
- از تکنیکهای تشخیص دادههای آلوده استفاده کنید.
- مدل را با دادههای تستی مختلف ارزیابی کنید.
- در صورت نیاز، از روشهای ضد مسمومسازی استفاده کنید.
با توجه به اهمیت دادهها در آموزش مدلهای هوش مصنوعی، توجه به کیفیت و صحت دادهها میتواند در جلوگیری از مسمومسازی داده و افزایش دقت مدلها بسیار مؤثر باشد. برای اطلاعات بیشتر در زمینه هوش مصنوعی و تکنیکهای پیشرفته، میتوانید به مقالات مرتبط در ماشین مگ مراجعه کنید.